【AWS CDK】Amazon DynamodbとAmazon OpenSearch Serverless のzero-ETL integrationを AWS CDK で構築する
- 前書き
- 注意点
- 参考リンク
- 環境
- 全体像
- 0. 事前準備
- 1. CDKのプロジェクト作成
- 2. S3
- 3. DynamoDB
- 4. IAM Role
- 5. Amazon OpenSearch Service
- 6. IAM Policy
- 7. Pipeline
- デプロイとテスト
- 削除
- まとめ
- CDKの定義全体
前書き
昨年末に公開された、DynamoDBとOpenSearch Serviceのzero-ETL integrationを AWS CDK で構築する例です。
本記事は、こちらのCLI手順のCDKバージョンです。
CLIとほぼ同じですが、CDKではリソース間に依存関係がある場合にはaddDependencyメソッドを使って明示してあげる必要があります。作成したリソースのIDを元にpolicyをしっかり縛りたい時には特に重要です。 また、pipelineの処理定義(yml)部分は現在文字列で渡すことになっています。CLIとTypeScriptでは埋め込み方が異なるので、その部分にも注意してください。
※先にCLI版の手順を試してみることをお勧めします。CLI版のリソース間の関係を理解していれば、依存関係の理解は難しくないと思います。
注意点
リソースは課金されます。 テストが終わったら削除しておきましょう。以下の手順を実行して発生する問題について、筆者は一切の責任を取ることができません。自己責任でお願いします。
参考リンク
AWS公式の紹介記事です。
Amazon DynamoDB の Amazon OpenSearch Service とのゼロ ETL 統合が利用可能になりました | Amazon Web Services ブログ
公式チュートリアルです。こちらはGUIベースです。本記事では、下のcollection(serverless)版のリソースを、AWS CLIを使って構築します。
Tutorial: Ingesting data into a domain using Amazon OpenSearch Ingestion - Amazon OpenSearch Service
DynamoDB zero-ETL integration with Amazon OpenSearch Service - Amazon DynamoDB
環境
| バージョン | |
|---|---|
| MacOS Sonoma | 14.4.1 |
| AWS CLI | 2.15.34 |
| AWS CDK | 2.145.0 |
| awscurl | 0.33 |
全体像
以下のリソースを作ります。

- Amazon S3
- Amazon DynamoDBのTable
- Amazon OpenSearch Service の collection
- 3種のポリシー
- Data access policies
- Encryption policies
- Network policies
- 3種のポリシー
- Pipeline
- IAM Role
- IAM Policy : OpenSearchとDynamoDBへのアクセス権
Pipelineは以下の働きをします。
- DynamoDBの監視(データが投入されたことを感知)
- OpenSearchへのデータ投入/削除/更新
- S3へバックアップなどをアップロード
また、Amazon OpenSearch Serviceはリソースベースのポリシーを持ちます。IAM RoleでAmazon OpenSearch Serviceへのアクセスを許可するだけではダメで、Amazon OpenSearch Serviceの Data access policies 側でもIAM Roleに対して許可を出す必要があります(後述)。
0. 事前準備
AWS CDKを利用できるようにしておきます。 また、CDKを実行するユーザに必要な権限をつけておきます。
1. CDKのプロジェクト作成
mkdir zero-etl-dynamodb-aoss
cd $_
cdk init app --language typescript
lib/zero-etl-dynamodb-aoss-stack.ts にコードを書いていきます。
import部分などは最後にまとめたコードを記載するので、そちらを参考にしてください。
2. S3
cdkをdestroyした時に削除されるように、removalPolicy(バケツ破壊)とautoDeleteObjects(中身破壊)を設定しておきます。
const s3bucket = new Bucket(this, 'S3Bucket', {
  bucketName: 'ingestion-dynamodb',
  removalPolicy: cdk.RemovalPolicy.DESTROY,
  autoDeleteObjects: true,
});
3. DynamoDB
このDynamoDBに投入したデータがPipelineによってOpenSearchに自動で投入される予定です。
partitionKeyとして文字列のname、sortKeyとして数値のageを使うことにします。
両者を合わせると一意になります。OpenSearchのidはname:ageという形になる想定です。
pointInTimeRecoveryとstreamの設定は必須です(厳密には後者だけでも以降の実験はできます)。こちらの設定によって、DynamoDBの内容をpipelineが検知してOpenSearchに投入できるようになります。
cdkでstackを削除した際にdynamoDBは破壊したいので、removalPolicyもつけておきます。
また、readCapacityとwriteCapacityを最小の1に設定しました(しなくてもいいです)
const table = new Table(this, 'DynamoDBTable', {
  tableName: 'ingestion-table',
  partitionKey: {name: 'name', type: AttributeType.STRING},
  sortKey: {name: 'age', type: AttributeType.NUMBER},
  pointInTimeRecovery: true,
  stream: StreamViewType.NEW_IMAGE,
  readCapacity: 1,
  writeCapacity: 1,
  removalPolicy: cdk.RemovalPolicy.DESTROY
});
4. IAM Role
PipelineのRoleを先に作っておきます。OpenSearchのData Access Policyに対して、このRoleのArnを指定してアクセス許可を出したいためです。
Pipeline用のRoleなので、trust policyの対象をosis-pipelines.amazonaws.comにしておきます。
const pipelineRole = new Role(this, 'pipelineRole', {
  roleName: 'PipelineRole',
  assumedBy: new ServicePrincipal('osis-pipelines.amazonaws.com')
});
5. Amazon OpenSearch Service
3種のポリシーと、collection本体を作成します。 また、2024年6月18日現在、L2コンストラクタが無いようなので、L1(Cfnが頭についているクラス)を使っています。
Data Access Policy
リソースポリシーです。先ほど作ったRoleに加え、CLIのユーザもprincipalに入れておくと良いです(テスト時にCLIからOpenSearchにリクエストできます)。
CLIユーザ名がわからなければ、CLIで aws sts get-caller-identity を実行すると良いです。
const cliUser = User.fromUserName(this, 'existingUser', 'local-cli-user');
const dataAccessPolicy = new CfnAccessPolicy(this, "OpenSearchAccessPolicy", {
  name: "cdk-access-policy",
  type: "data",
  policy: JSON.stringify([
    {
      "Rules": [
        {
          "Resource": [`index/${collection.name}/*`],
          "Permission": [
            "aoss:CreateIndex",
            "aoss:UpdateIndex",
            "aoss:DescribeIndex",
            "aoss:ReadDocument",
            "aoss:WriteDocument"
          ],
          "ResourceType": "index"
        }
      ],
      "Principal": [ cliUser.userArn, pipelineRole.roleArn]
    }
  ]),
});
Encryption Policy
collectionのデータ暗号化の設定のため、Encryption Policyを定義します。Resource項目で先ほど定義したcollection.nameを利用しています。
const encryptionPolicy = new CfnSecurityPolicy(this, 'OpenSearchEncryptionPolicy', {
      name: 'encryption-policy',
      type: 'encryption',
      policy: JSON.stringify({
        "Rules": [
          {
            "ResourceType": "collection",
            "Resource": [`collection/${collection.name}`]
          }
        ],
        "AWSOwnedKey": true
      }),
    });
encryption policyは、collection作成前に存在している必要があります。 そのため、addDependencyメソッドを定義して依存関係を明示しておきましょう。
// NOTE CollectionはencryptionPolicyに依存している。
collection.addDependency(encryptionPolicy)
Network Policy
実験しやすいよう、publicアクセスができるようにしておきます。
const networkPolicy = new CfnSecurityPolicy(this, 'OpenSearchNetworkPolicy', {
  name: "network-policy",
  type: "network",
  policy: JSON.stringify([
    {
      "Rules": [
        {
          "ResourceType": "dashboard",
          "Resource": [ `collection/${collection.name}`]
        },
        {
          "ResourceType": "collection",
          "Resource": [ `collection/${collection.name}`]
        },
      ],
      "AllowFromPublic": true,
    }
  ])
});
6. IAM Policy
pipelineのRoleに付与するPolicyを作成します。(上記で作成したcollectionのidが必要なので、policyはこのタイミングまで作らずにいました。)
公式tutorialに従ってやや厳しめに設定していますが、実験用ならもっとラフでも良い気もします。
const pipelinePolicy = new Policy(this, 'pipelinePolicy', {
  policyName: 'pipelinePolicy',
  statements: [
    new PolicyStatement({
      effect: Effect.ALLOW,
      actions: [
        "dynamodb:DescribeTable",
        "dynamodb:DescribeContinuousBackups",
        "dynamodb:ExportTableToPointInTime"
      ],
      resources: [`${table.tableArn}`]
    }),
    new PolicyStatement({
      effect: Effect.ALLOW,
      actions: [
        "dynamodb:DescribeExport"
      ],
      resources: [`${table.tableArn}/export/*`]
    }),
    new PolicyStatement({
      effect: Effect.ALLOW,
      actions: [
        "dynamodb:DescribeStream",
        "dynamodb:GetRecords",
        "dynamodb:GetShardIterator"
      ],
      resources: [`${table.tableArn}/stream/*`]
    }),
    new PolicyStatement({
      effect: Effect.ALLOW,
      actions: [
        "s3:GetObject",
        "s3:AbortMultipartUpload",
        "s3:PutObject",
        "s3:PutObjectAcl"
      ],
      resources: [ `${s3bucket.bucketArn}/*` ]
    }),
    new PolicyStatement({
      effect: Effect.ALLOW,
      actions: [
        "aoss:BatchGetCollection",
        "aoss:APIAccessAll"
      ],
      resources: [
        `${collection.attrArn}`
      ]
    }),
    new PolicyStatement({
      effect: Effect.ALLOW,
      actions: [
        "aoss:CreateSecurityPolicy",
        "aoss:GetSecurityPolicy",
        "aoss:UpdateSecurityPolicy"
      ],
      resources: ['*'],
      conditions: {
        StringEquals: {
          "aoss:collection": collection.name
        }
      }
    }),
  ]
});
(重要) policyはRoleにアタッチしておきます
pipelinePolicy.attachToRole(pipelineRole)
7. Pipeline
pipelineを定義します。
ETL処理の定義(pipelineConfigurationBody)は、残念ながら文字列として定義するしか無いようです。 せっかくTypeScriptなのに... L2のコンストラクタが出るのを待ちましょう。
雛形となる文字列が欲しければ、以下で取得してください。詳しくは、自分が書いたCLI版の記事に記載してあります。
aws osis get-pipeline-blueprint --blueprint-name AWS-DynamoDBChangeDataCapturePipeline --query Blueprint.PipelineConfigurationBody --output text > blueprint.yml
コードは以下のようになります。
CLI版と比べてindexまわりのエスケープの書き方を変更しています。 yamlをこのように書くのはミスも発生しやすく厳しいので、objectで書いた後に変換するなどした方が良さそうです(未検討)
const pipelineConfiguration = `
version: "2"
dynamodb-pipeline:
  source:
    dynamodb:
      acknowledgments: true
      tables:
        - table_arn: "${table.tableArn}"
          stream:
            start_position: "LATEST"
          export:
            s3_bucket: "${s3bucket.bucketName}"
            s3_region: "${this.region}"
            s3_prefix: "opensearch-export/"
      aws:
        sts_role_arn: "${pipelineRole.roleArn}"
        region: "${this.region}"
  sink:
    - opensearch:
        hosts:
          - "${collection.attrCollectionEndpoint}"
        index: '\${getMetadata("table_name")}'
        index_type: "custom"
        normalize_index: true
        document_id: '\${getMetadata("primary_key")}'
        action: '\${getMetadata("opensearch_action")}'
        document_version: '\${getMetadata("document_version")}'
        document_version_type: "external"
        aws:
          sts_role_arn: "${pipelineRole.roleArn}"
          region: "${this.region}"
          serverless: true
        dlq:
          s3:
            bucket: "${s3bucket.bucketName}"
            key_path_prefix: "dynamodb-pipeline/dlq"
            region: "${this.region}"
            sts_role_arn: "${pipelineRole.roleArn}"
`;
const pipeline = new CfnPipeline(this, "pipeline", {
  pipelineConfigurationBody: pipelineConfiguration,
  pipelineName: 'serverless-ingestion',
  minUnits: 1,
  maxUnits: 2,
});
デプロイとテスト
デプロイします。確認画面が出たら、yを押して進みましょう。
cdk deploy
完了したら、DynamoDBにデータを投入してみます。
TABLE_NAME=ingestion-table
aws dynamodb put-item \
    --table-name $TABLE_NAME \
    --item '{"name": {"S": "saki"}, "age": {"N": "16"}, "height": {"N": "152"}}'
aws dynamodb put-item \
    --table-name $TABLE_NAME \
    --item '{"name": {"S": "temari"}, "age": {"N": "15"}, "height": {"N": "162"}}'
aws dynamodb put-item \
    --table-name $TABLE_NAME \
    --item '{"name": {"S": "kotone"}, "age": {"N": "15"}, "height": {"N": "156"}}'
OpenSearchを確認します。反映されるまで、少し時間がかかるかもしれません。
export AWS_DEFAULT_REGION='ap-northeast-1'
COLLECTION_NAME=ingestion-collection
HOST=$(aws opensearchserverless batch-get-collection --names $COLLECTION_NAME --query 'collectionDetails[].collectionEndpoint' --output text) && echo $HOST
awscurl --service aoss --region $AWS_DEFAULT_REGION -X GET ${HOST}/_cat/indices
awscurl --service aoss --region $AWS_DEFAULT_REGION -X GET ${HOST}/${TABLE_NAME}/_search | jq .
DynamoDBに導入したデータが、OpenSearchに反映されていれば成功です!
削除
以下のコマンドで削除します。S3もDynamoDBも、CDKのスタックとともに削除される設定になっているので削除されるはずです。今回はログも設定してないので、何も残らないと思います。(何かリソースが残っていたら教えてください)
cdk destroy
まとめ
Amazon DynamodbとAmazon OpenSearch Serviceのzero-ETL integrationをAWS CDKで構築する手順をまとめました。
pipelineのyamlがまだ文字列でしか指定できないのが少し不便ですね。 L2のコンストラクタが出れば、objectで指定できてTypeScriptの型の補助も受けられるのかなと思っています。
CDKの定義全体
以下はコード全体です。
import * as cdk from 'aws-cdk-lib';
import { AttributeType, StreamViewType, Table } from 'aws-cdk-lib/aws-dynamodb';
import { Effect, Policy, PolicyStatement, Role, ServicePrincipal, User } from 'aws-cdk-lib/aws-iam';
import { CfnAccessPolicy, CfnCollection, CfnSecurityPolicy } from 'aws-cdk-lib/aws-opensearchserverless';
import { CfnPipeline } from 'aws-cdk-lib/aws-osis';
import { Bucket } from 'aws-cdk-lib/aws-s3';
import { Construct } from 'constructs';

export class ZeroEtlDynamodbAossStack extends cdk.Stack {
constructor(scope: Construct, id: string, props?: cdk.StackProps) {
super(scope, id, props);


const s3bucket = new Bucket(this, 'S3Bucket', {
  bucketName: 'ingestion-dynamodb',
  removalPolicy: cdk.RemovalPolicy.DESTROY,
  autoDeleteObjects: true,
});

const table = new Table(this, 'DynamoDBTable', {
  tableName: 'ingestion-table',
  partitionKey: {name: 'name', type: AttributeType.STRING},
  sortKey: {name: 'age', type: AttributeType.NUMBER},
  readCapacity: 1,
  writeCapacity: 1,
  pointInTimeRecovery: true,
  stream: StreamViewType.NEW_IMAGE,
  removalPolicy: cdk.RemovalPolicy.DESTROY
});

// Piepline用のRole
const pipelineRole = new Role(this, 'pipelineRole', {
  roleName: 'PipelineRole',
  assumedBy: new ServicePrincipal('osis-pipelines.amazonaws.com'),
});

// AOSS Collection
const collection = new CfnCollection(this, "OpenSearchCollection", {
  name: "ingestion-collection",
  type: "SEARCH",
  standbyReplicas: "DISABLED",
});

// AOSS Data Access Policy
const cliUser = User.fromUserName(this, 'existingUser', 'local-cli-user');
const dataAccessPolicy = new CfnAccessPolicy(this, "OpenSearchAccessPolicy", {
  name: "access-policy",
  type: "data",
  policy: JSON.stringify([
    {
      "Rules": [
        {
          "Resource": [`index/${collection.name}/*`],
          "Permission": [
            "aoss:CreateIndex",
            "aoss:UpdateIndex",
            "aoss:DescribeIndex",
            "aoss:ReadDocument",
            "aoss:WriteDocument"
          ],
          "ResourceType": "index"
        }
      ],
      "Principal": [ cliUser.userArn, pipelineRole.roleArn]
    }
  ]),
});

// AOSS Encryption Policy
const encryptionPolicy = new CfnSecurityPolicy(this, 'OpenSearchEncryptionPolicy', {
      name: 'encryption-policy',
      type: 'encryption',
      policy: JSON.stringify({
        "Rules": [
          {
            "ResourceType": "collection",
            "Resource": [`collection/${collection.name}`]
          }
        ],
        "AWSOwnedKey": true
      }),
    });

// NOTE CollectionはencryptionPolicyに依存している。
collection.addDependency(encryptionPolicy)

// AOSS Network Policy
const networkPolicy = new CfnSecurityPolicy(this, 'OpenSearchNetworkPolicy', {
  name: "network-policy",
  type: "network",
  policy: JSON.stringify([
    {
      "Rules": [
        {
          "ResourceType": "dashboard",
          "Resource": [ `collection/${collection.name}`]
        },
        {
          "ResourceType": "collection",
          "Resource": [ `collection/${collection.name}`]
        },
      ],
      "AllowFromPublic": true,
    }
  ])
});

const pipelinePolicy = new Policy(this, 'pipelinePolicy', {
  policyName: 'pipelinePolicy',
  statements: [
    new PolicyStatement({
      effect: Effect.ALLOW,
      actions: [
        "dynamodb:DescribeTable",
        "dynamodb:DescribeContinuousBackups",
        "dynamodb:ExportTableToPointInTime"
      ],
      resources: [`${table.tableArn}`]
    }),
    new PolicyStatement({
      effect: Effect.ALLOW,
      actions: [
        "dynamodb:DescribeExport"
      ],
      resources: [`${table.tableArn}/export/*`]
    }),
    new PolicyStatement({
      effect: Effect.ALLOW,
      actions: [
        "dynamodb:DescribeStream",
        "dynamodb:GetRecords",
        "dynamodb:GetShardIterator"
      ],
      resources: [`${table.tableArn}/stream/*`]
    }),
    new PolicyStatement({
      effect: Effect.ALLOW,
      actions: [
        "s3:GetObject",
        "s3:AbortMultipartUpload",
        "s3:PutObject",
        "s3:PutObjectAcl"
      ],
      resources: [ `${s3bucket.bucketArn}/*` ]
    }),
    new PolicyStatement({
      effect: Effect.ALLOW,
      actions: [
        "aoss:BatchGetCollection",
        "aoss:APIAccessAll"
      ],
      resources: [
        `${collection.attrArn}`
      ]
    }),
    new PolicyStatement({
      effect: Effect.ALLOW,
      actions: [
        "aoss:CreateSecurityPolicy",
        "aoss:GetSecurityPolicy",
        "aoss:UpdateSecurityPolicy"
      ],
      resources: ['*'],
      conditions: {
        StringEquals: {
          "aoss:collection": collection.name
        }
      }
    }),
  ]
});
pipelinePolicy.attachToRole(pipelineRole)

const pipelineConfiguration = `
version: "2"
dynamodb-pipeline:
  source:
    dynamodb:
      acknowledgments: true
      tables:
        - table_arn: "${table.tableArn}"
          stream:
            start_position: "LATEST"
          export:
            s3_bucket: "${s3bucket.bucketName}"
            s3_region: "${this.region}"
            s3_prefix: "opensearch-export/"
      aws:
        sts_role_arn: "${pipelineRole.roleArn}"
        region: "${this.region}"
  sink:
    - opensearch:
        hosts:
          - "${collection.attrCollectionEndpoint}"
        index: '\${getMetadata("table_name")}'
        index_type: "custom"
        normalize_index: true
        document_id: '\${getMetadata("primary_key")}'
        action: '\${getMetadata("opensearch_action")}'
        document_version: '\${getMetadata("document_version")}'
        document_version_type: "external"
        aws:
          sts_role_arn: "${pipelineRole.roleArn}"
          region: "${this.region}"
          serverless: true
        dlq:
          s3:
            bucket: "${s3bucket.bucketName}"
            key_path_prefix: "dynamodb-pipeline/dlq"
            region: "${this.region}"
            sts_role_arn: "${pipelineRole.roleArn}"
`;
const pipeline = new CfnPipeline(this, "pipeline", {
  pipelineConfigurationBody: pipelineConfiguration,
  pipelineName: 'serverless-ingestion',
  minUnits: 1,
  maxUnits: 2,
});

pipeline.node.addDependency(pipelinePolicy);
pipeline.node.addDependency(collection);

}
}
【AWS CLI】Amazon DynamoDBとAmazon OpenSearch Serverlessのzero-ETL integrationを AWS CLI で構築する
- 前書き
- 注意点
- 参考リンク
- 環境
- 全体像
- 0. 事前準備
- 1. S3とDynamoDBの作成
- 2. PipelineのRoleを作成
- 3. Amazon OpenSearch Collectionの作成
- 4. Policyの作成
- 5. Pipelineの作成
- 6. テスト実行
- リソースの削除
- 余談: ChatGPT と AWS CLI
- まとめ
前書き
2023年の年末に公開された、DynamoDBとOpenSearch Serviceのzero-ETL integrationを AWS CLI で構築する手順を記録しておきます。 zero-ETL integrationは、DynamoDBに投入したデータをOpenSearch Serviceに同期させる仕組みです。 イベントを拾ってLambdaでOpenSearchに投入する処理を自前で書く必要が無くなるため、コーディングの面でもリソース管理の面でも便利になるはずです。
以下の作業は全てコピペで実行できます。(※削除手順も記載してあります)
注意点
リソースは課金されます。 テストが終わったら削除しておきましょう。以下の手順を実行して発生する問題について、筆者は一切の責任を取ることができません。自己責任でお願いします。
参考リンク
AWS公式の紹介記事です。
Amazon DynamoDB の Amazon OpenSearch Service とのゼロ ETL 統合が利用可能になりました | Amazon Web Services ブログ
公式チュートリアルです。こちらはGUIベースです。本記事では、下のcollection(serverless)版のリソースを、AWS CLIを使って構築します。
Tutorial: Ingesting data into a domain using Amazon OpenSearch Ingestion - Amazon OpenSearch Service
DynamoDB zero-ETL integration with Amazon OpenSearch Service - Amazon DynamoDB
AWS CLIの基本となる実行手順について、以下のシリーズを参考にさせていただいています。
環境
| バージョン | |
|---|---|
| MacOS Sonoma | 14.4.1 |
| AWS CLI | 2.15.34 |
| awscurl | 0.33 |
全体像
以下のリソースを作ります。
- Amazon S3
- Amazon DynamoDBのTable
- Amazon OpenSearch Service の collection
- 3種のポリシー
- Data access policies
- Encryption policies
- Network policies
- 3種のポリシー
- Pipeline
- IAM Role
- IAM Policy : OpenSearchとDynamoDBへのアクセス権
Pipelineは以下の働きをします。
- DynamoDBの監視(データが投入されたことを感知)
- OpenSearchへのデータ投入/削除/更新
- S3へバックアップなどをアップロード
また、Amazon OpenSearch Serviceはリソースベースのポリシーを持ちます。 IAM RoleでAmazon OpenSearch Serviceへのアクセスを許可するだけでは不十分で、Amazon OpenSearch Serviceの Data access policies でIAM Roleに対して許可を出す必要があります(後述)。
0. 事前準備
AWS CLIを利用できるようにしておきます。 また、CLIを実行するユーザに必要な権限をつけておきます。
作成するリソース名などを、変数で定義しておきます。以下をシェルで実行し、後半の手順に進んでください。
export AWS_DEFAULT_REGION='ap-northeast-1'

COLLECTION_NAME=ingestion-collection
PIPELINE_NAME=serverless-ingestion

TABLE_NAME=ingestion-table

BUCKET_NAME="ingestion-dynamodb"
BUCKET_ARN=arn:aws:s3:::${BUCKET_NAME} && echo $BUCKET_ARN
PATH_PREFIX1="opensearch-export"
PATH_PREFIX2="dynamodb-pipeline"

IAM_POLICY_NAME=pipeline-policy
IAM_ROLE_NAME=PipelineRole
ACCOUNT_ID=$(aws sts get-caller-identity --query 'Account' --output text) && echo $ACCOUNT_ID
COLLECTION_ARN="arn:aws:es:${AWS_DEFAULT_REGION}:${ACCOUNT_ID}:domain/${COLLECTION_NAME}" && echo $COLLECTION_ARN
1. S3とDynamoDBの作成
S3のBucketを作成します。
aws s3api create-bucket --bucket $BUCKET_NAME --create-bucket-configuration LocationConstraint=$AWS_DEFAULT_REGION
完了確認をします。指定した名前のbucketができていれば成功です。
aws s3 ls | grep $BUCKET_NAME
DynamoDBを作成します。 今回は、nameとageフィールドを持ち、スループットを最小に固定したテーブルを作成することにします。(適当に変更しても大丈夫です)
aws dynamodb create-table \
    --table-name $TABLE_NAME \
    --attribute-definitions \
        AttributeName=name,AttributeType=S \
        AttributeName=age,AttributeType=N \
    --key-schema \
        AttributeName=name,KeyType=HASH \
        AttributeName=age,KeyType=RANGE \
    --provisioned-throughput \
        ReadCapacityUnits=1,WriteCapacityUnits=1
完了確認を兼ねて、テーブルのARNを取得しておきます。
TABLE_ARN=$(aws dynamodb describe-table --table-name $TABLE_NAME --query Table.TableArn --output text) && echo $TABLE_ARN
PITR(Point-in-Time-Recovery)の有効化を行います。OpenSearch Ingestion初期データ利用時に必要です。
aws dynamodb update-continuous-backups --table-name $TABLE_NAME --point-in-time-recovery-specification PointInTimeRecoveryEnabled=true

# 確認
aws dynamodb describe-continuous-backups --table-name $TABLE_NAME
DynamoDB StreamをNEW_IMAGEに変更します。 ( ※変更発生時、新しいイメージをキャプチャできるようになります。)
aws dynamodb update-table --table-name $TABLE_NAME --stream-specification StreamEnabled=true,StreamViewType=NEW_IMAGE

# 確認
aws dynamodb describe-table --table-name $TABLE_NAME --query Table.StreamSpecification
2. PipelineのRoleを作成
先にRoleだけ作ります。Policyは手順4で作成します(collectionを作成し、そのIDを手に入れてからpolicyを作成したいためです。)
まずは Trust policy をファイルに保存しておきます。 「このRoleを使うのはosis-pipelines.amazonaws.comですよ」と示すためのものです。
IAM_ROLE_PRINCIPAL='osis-pipelines.amazonaws.com'
FILE_IAM_ROLE_DOC="role-document.json"

cat << EOF > ${FILE_IAM_ROLE_DOC}
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Action": "sts:AssumeRole",
      "Principal": {
        "Service": "${IAM_ROLE_PRINCIPAL}"
      },
      "Effect": "Allow",
      "Sid": ""
    }
  ]
}
EOF
cat ${FILE_IAM_ROLE_DOC}
上記のTrust policyを指定してRoleを作成します。
aws iam create-role --role-name $IAM_ROLE_NAME --assume-role-policy-document file://$FILE_IAM_ROLE_DOC
作成したRoleを確認します。
aws iam list-roles --query "Roles[?RoleName == '${IAM_ROLE_NAME}'].RoleName"
3. Amazon OpenSearch Collectionの作成
少し複雑ですが、以下のリソースを作成します。
- Data access policies
- リソースポリシーです。先ほど作成したRoleにアクセス許可を出します。
- Encryption policies
- 必須です。OpenSearch collection保存データの暗号化方法を指定します。
- Network policies
- collection
- 今回はDomainではなく、OpenSearchのserverless版を使います。
ポイント: 中間テーブルのようなオブジェクトはありません。単に作る予定のcollection名を指定した各種ポリシーを前もって作成しておくことでポリシーを有効化します。 特にEncryption policiesは先に作っておかないと、collectionを作成することができません。
Data access policiesの作成
policy documentをファイルに保存しておきます。 今回はCLIユーザと先ほど作成したRoleを許可します。GUIでも確認したければ、AWSのマネコンにログインしているユーザも追加で指定してください。(後から追加することもできます)
FILE_ACCESS_POLICY_DOC="access-policy-document.json"

CALLER_ARN=$(aws sts get-caller-identity --query Arn --output text) && echo $CALLER_ARN
IAM_ROLE_ARN=$(aws iam get-role --role-name $IAM_ROLE_NAME --query Role.Arn --output text) && echo $IAM_ROLE_ARN

cat << EOS > $FILE_ACCESS_POLICY_DOC
[
  {
    "Rules": [
      {
        "Resource": [
          "index/${COLLECTION_NAME}/*"
        ],
        "Permission": [
          "aoss:CreateIndex",
          "aoss:UpdateIndex",
          "aoss:DescribeIndex",
          "aoss:ReadDocument",
          "aoss:WriteDocument"
        ],
        "ResourceType": "index"
      }
    ],
    "Principal": [
      "${IAM_ROLE_ARN}",
      "${CALLER_ARN}"
    ],
    "Description": "Rule 1"
  }
]
EOS
cat $FILE_ACCESS_POLICY_DOC
Data access policiesを作成します。
詳しくはaws opensearchserverless create-access-policy helpをみてください。
なお、2024/06現在 typeはdata以外選択できません。
ACCESS_POLICY_NAME=access-policy
aws opensearchserverless create-access-policy --name $ACCESS_POLICY_NAME --policy file://$FILE_ACCESS_POLICY_DOC --type data
Encryption policiesの作成
policy documentをファイルに保存しておきます。今回はAWSが提供するkeyを使うので、AWSOwnedKeyをtrueにします。
FILE_ENC_POLICY_DOC="access-policy-document.json"
cat << EOS > $FILE_ENC_POLICY_DOC
{
  "Rules": [
    {
      "ResourceType": "collection",
      "Resource": [ "collection/${COLLECTION_NAME}" ]
    }
  ],
  "AWSOwnedKey": true
}
EOS
cat $FILE_ENC_POLICY_DOC
Encryption policiesを作成します。 わかりにくいですが、こちらはcreate-security-policyのAPIを使い、typeとしてencryptionを指定します。
ENC_POLICY_NAME=encryption-policy
aws opensearchserverless create-security-policy --name $ENC_POLICY_NAME --policy file://$FILE_ENC_POLICY_DOC --type encryption
Network policiesの作成
Network policiesを作成します。 policy documentをまずファイルに書き込みます
FILE_NET_POLICY_DOC="access-policy-document.json"
cat << EOS > $FILE_NET_POLICY_DOC
[
  {
    "Rules": [
      {
        "ResourceType": "dashboard",
        "Resource": [ "collection/${COLLECTION_NAME}"]
      },
      {
        "ResourceType": "collection",
        "Resource": [ "collection/${COLLECTION_NAME}"]
      }
    ],
    "AllowFromPublic": true
  }
]
EOS
cat $FILE_NET_POLICY_DOC
Network policiesを作成します。 わかりにくいですが、こちらはcreate-security-policyのAPIを使い、typeとしてnetworkを指定します。
NET_POLICY_NAME=network-policy
aws opensearchserverless create-security-policy --name $NET_POLICY_NAME --policy file://$FILE_NET_POLICY_DOC --type network
Collectionを作成します。 テスト用なのでreplicasは無効にして、typeはSEARCHにしておきます。
aws opensearchserverless create-collection --name $COLLECTION_NAME --standby-replicas DISABLED --type SEARCH
4. Policyの作成
pipelineに付与するPolicyを作成します。
まずは必要な権限をJSONで記載し、ファイルに保存しておきます。
COLLECTION_ID=$(aws opensearchserverless batch-get-collection --names $COLLECTION_NAME --query 'collectionDetails[].id' --output text) && echo $COLLECTION_ID

FILE_IAM_POLICY_DOC="policy-document.json"
cat << EOS > $FILE_IAM_POLICY_DOC
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Sid": "allowRunExportJob",
      "Effect": "Allow",
      "Action": [
        "dynamodb:DescribeTable",
        "dynamodb:DescribeContinuousBackups",
        "dynamodb:ExportTableToPointInTime"
      ],
      "Resource": [ "${TABLE_ARN}" ]
    },
    {
      "Sid": "allowCheckExportjob",
      "Effect": "Allow",
      "Action": [
        "dynamodb:DescribeExport"
      ],
      "Resource": [ "${TABLE_ARN}/export/*" ]
    },
    {
      "Sid": "allowReadFromStream",
      "Effect": "Allow",
      "Action": [
        "dynamodb:DescribeStream",
        "dynamodb:GetRecords",
        "dynamodb:GetShardIterator"
      ],
      "Resource": [ "${TABLE_ARN}/stream/*" ]
    },
    {
      "Sid": "allowReadAndWriteToS3ForExport",
      "Effect": "Allow",
      "Action": [
        "s3:GetObject",
        "s3:AbortMultipartUpload",
        "s3:PutObject",
        "s3:PutObjectAcl"
      ],
      "Resource": [
        "${BUCKET_ARN}/${PATH_PREFIX1}/*",
        "${BUCKET_ARN}/${PATH_PREFIX2}/*"
      ]
    },
    {
      "Action": [
        "aoss:BatchGetCollection",
        "aoss:APIAccessAll"
      ],
      "Effect": "Allow",
      "Resource": "arn:aws:aoss:${AWS_DEFAULT_REGION}:${ACCOUNT_ID}:collection/${COLLECTION_ID}"
    },
    {
      "Action": [
        "aoss:CreateSecurityPolicy",
        "aoss:GetSecurityPolicy",
        "aoss:UpdateSecurityPolicy"
      ],
      "Effect": "Allow",
      "Resource": "*",
      "Condition": {
        "StringEquals": {
          "aoss:collection": "${COLLECTION_NAME}"
        }
      }
    }
  ]
}
EOS
cat $FILE_IAM_POLICY_DOC
Policyを作成します。
aws iam create-policy --policy-name ${IAM_POLICY_NAME} --policy-document file://$FILE_IAM_POLICY_DOC
作成したPolicyを確認します。
IAM_POLICY_ARN="arn:aws:iam::${ACCOUNT_ID}:policy/${IAM_POLICY_NAME}" && echo $IAM_POLICY_ARN
aws iam get-policy --policy-arn $IAM_POLICY_ARN
手順2で作成したpipeline用のRoleに、Policyを紐つけます。
aws iam attach-role-policy --role-name $IAM_ROLE_NAME --policy-arn $IAM_POLICY_ARN
Policyが紐ついていることを確認します。
aws iam list-attached-role-policies --role-name $IAM_ROLE_NAME
5. Pipelineの作成
こちらの公式ドキュメントも参考にしてください。
Amazon OpenSearch Ingestion パイプラインの作成 - Amazon OpenSearch サービス
PipelineのETL処理に当たる部分はymlで定義します。0から記載するのは大変なので、公式が用意しているblueprintを使います。 blueprintの一覧を確認し、DynamoDBの名前が入っているものを探します。
aws osis list-pipeline-blueprints
AWS-DynamoDBChangeDataCapturePipelineを使いましょう。
blueprintを手に入れます。
aws osis get-pipeline-blueprint --blueprint-name AWS-DynamoDBChangeDataCapturePipeline --query Blueprint.PipelineConfigurationBody --output text > blueprint.yml
blueprintを元に、ETL(DynamoDBのテーブルの中身をOpenSearchにコピーする)に必要な情報を設定していきます。
hostsの設定内容については、collectionが作成完了し、endpointが手に入るまでしばらく待ちます。 以下のコマンドがCREATINGだと、endpointが得られません。ACTIVEになるまで待ちます。
aws opensearchserverless batch-get-collection --names $COLLECTION_NAME --query 'collectionDetails[].status'
collectionが完了していれば、以下を使ってymlを書いてもOKです。(blueprintを編集した後の内容例です。)
TABLE_ARN=$(aws dynamodb describe-table --table-name $TABLE_NAME --query Table.TableArn --output text) && echo $TABLE_ARN
IAM_ROLE_ARN=$(aws iam get-role --role-name $IAM_ROLE_NAME --query Role.Arn --output text) && echo $IAM_ROLE_ARN
HOST=$(aws opensearchserverless batch-get-collection --names $COLLECTION_NAME --query 'collectionDetails[].collectionEndpoint' --output text) && echo $HOST

FILE_INGESTION_DOCUMENT=injestion.yml

cat << EOS > $FILE_INGESTION_DOCUMENT
version: "2"
dynamodb-pipeline:
  source:
    dynamodb:
      acknowledgments: true
      tables:
        - table_arn: "${TABLE_ARN}"
          stream:
            start_position: "LATEST"
          export:
            s3_bucket: "${BUCKET_NAME}"
            s3_region: "${AWS_DEFAULT_REGION}"
            s3_prefix: "${PATH_PREFIX1}/"
      aws:
        sts_role_arn: "${IAM_ROLE_ARN}"
        region: "${AWS_DEFAULT_REGION}"
  sink:
    - opensearch:
        hosts:
          [
            "${HOST}"
          ]
        index: "\${getMetadata(\"table_name\")}"
        index_type: custom
        normalize_index: true
        document_id: "\${getMetadata(\"primary_key\")}"
        action: "\${getMetadata(\"opensearch_action\")}"
        document_version: "\${getMetadata(\"document_version\")}"
        document_version_type: "external"
        aws:
          sts_role_arn: "${IAM_ROLE_ARN}"
          region: "${AWS_DEFAULT_REGION}"
          serverless: true
        dlq:
          s3:
            bucket: "${BUCKET_NAME}"
            key_path_prefix: "${PATH_PREFIX2}/dlq"
            region: "${AWS_DEFAULT_REGION}"
            sts_role_arn: "${IAM_ROLE_ARN}"
EOS
cat $FILE_INGESTION_DOCUMENT
パイプラインを作成します。 min/max-unitは読み書きのcapacityで、時間あたりの課金に影響します。 OpenSearch Compute Unit (OCU)と言われる単位です。
aws osis create-pipeline \
      --pipeline-name $PIPELINE_NAME \
      --min-units 1\
      --max-units 2\
      --pipeline-configuration-body file://${FILE_INGESTION_DOCUMENT}
こちらも作成に時間が数分かかります。
6. テスト実行
DynamoDBにデータを投入してみます。
aws dynamodb put-item \
    --table-name $TABLE_NAME \
    --item '{"name": {"S": "saki"}, "age": {"N": "16"}, "height": {"N": "152"}}'
aws dynamodb put-item \
    --table-name $TABLE_NAME \
    --item '{"name": {"S": "temari"}, "age": {"N": "15"}, "height": {"N": "162"}}'
aws dynamodb put-item \
    --table-name $TABLE_NAME \
    --item '{"name": {"S": "kotone"}, "age": {"N": "15"}, "height": {"N": "156"}}'
OpenSearchを確認します。反映されるまで、少し時間がかかるかもしれません。
awscurl --service aoss --region $AWS_DEFAULT_REGION -X GET ${HOST}/_cat/indices
awscurl --service aoss --region $AWS_DEFAULT_REGION -X GET ${HOST}/${TABLE_NAME}/_search | jq .
以下のように、DynamoDBに投入したデータがOpenSearchに反映されていれば成功です!
{
  "took": 1494,
  "timed_out": false,
  "_shards": {
    "total": 0,
    "successful": 0,
    "skipped": 0,
    "failed": 0
  },
  "hits": {
    "total": {
      "value": 3,
      "relation": "eq"
    },
    "max_score": 1,
    "hits": [
      {
        "_index": "ingestion-table",
        "_id": "temari|15",
        "_score": 1,
        "_source": {
          "name": "temari",
          "age": 15,
          "height": 162
        }
      },
      {
        "_index": "ingestion-table",
        "_id": "kotone|15",
        "_score": 1,
        "_source": {
          "name": "kotone",
          "age": 15,
          "height": 156
        }
      },
      {
        "_index": "ingestion-table",
        "_id": "saki|16",
        "_score": 1,
        "_source": {
          "name": "saki",
          "age": 16,
          "height": 152
        }
      }
    ]
  }
}
リソースの削除
以下の順にリソースを削除していきます。
Pipeline
aws osis delete-pipeline --pipeline-name $PIPELINE_NAME
Amazon OpenSearch Service Collection
COLLECTION_ID=$( aws opensearchserverless list-collections --query "collectionSummaries[?name=='${COLLECTION_NAME}'].id" --output text) && $COLLECTION_ID
aws opensearchserverless delete-collection  --id $COLLECTION_ID
Amazon OpenSearch Service 3種のポリシー
aws opensearchserverless delete-access-policy --name $ACCESS_POLICY_NAME --type data
aws opensearchserverless delete-security-policy --name $ENC_POLICY_NAME --type encryption
aws opensearchserverless delete-security-policy --name $NET_POLICY_NAME --type network
Amazn DynamoDB
aws dynamodb delete-table --table-name $TABLE_NAME
Amazn S3
aws s3 rm s3://$BUCKET_NAME --recursive
aws s3api delete-bucket --bucket $BUCKET_NAME
Pipelineに付与していたPolicyとRole
aws iam detach-role-policy --role-name $IAM_ROLE_NAME --policy-arn $IAM_POLICY_ARN
aws iam delete-policy --policy-arn $IAM_POLICY_ARN
aws iam delete-role --role-name $IAM_ROLE_NAME
余談: ChatGPT と AWS CLI
AWS CLI や CDK はChatGPTと相性がよく、指示が適切であればリソース作成においてとても便利です。しかし、複数のリソースを組み合わせた正確な構成手順を一度に出力するのはまだまだ難しいようです。
個人的にChatGPTが便利だと感じるのは以下のケースです。
AWS CLI や CDK はリソースの作成手順を残せると言う意味で重宝していますが、パラメータなどを調べるのがやや面倒です。 個人的にはaws cliのヘルプとCDKの予測変換とドキュメント(typescript)を併用しつつ、ChatGPTに質問しながら最終的にCDKのコードに落とし込むのが一番楽だと感じています。
まとめ
Amazon DynamodbとAmazon OpenSearch Serviceのzero-ETL integrationをAWS CLIで構築する手順をまとめました。 AWSはリソースが色々あってややこしいですが、GUIのチュートリアルをこなした後に同じものをCLIで構築し、ノートにまとめておくと理解が深まると思っています。 CDKはCLIと同じAPIの上に作られているので、後々CDKを記述する時も楽になります。
【Django】例文で理解するselect_relatedとprefetch_relatedパターン集
- 前書き
- 参考リンク
- 環境
- 事前準備: モデルの作成とデータ投入
- No.0 発行されたSQLを確認する
- No.1 select_relatedで親を取る
- No.2 select_relatedで親の親を取る
- No.3 prefetch_relatedで複数件の多を取る
- No.4 Prefetchオブジェクトで多をfilter
- No.5 prefetch_relatedで2つ先のリレーション: ManyToMany-ManyToMany
- No.6 prefetch_relatedで2つ先のリレーション: ForeignKey-ManyToMany
- No.7 prefetch_relatedで2つ先のリレーション: ForeignKey-ManyToMany + select_related
- No.8 Prefetchで2つ先のリレーションをorder_byする
- No.9 prefetch_relatedで2つ先のリレーション: ManyToMany-ForeignKey
- No.10 to_attrで複数の絞り込みをする
- No.11 1つ先、2つ先のリレーションをそれぞれ条件付きでPrefetch(ManyToMany-ManyToMany)
- No.12 親ベースで1件の子を取得する
前書き
去年末もDjangoを書いてました。
DjangoのORMは簡潔な記述でSQLの発行とPythonオブジェクトを橋渡ししてくれて便利です。
しかし何も考えずに使っているとSQLの発行数が増えてきて、パフォーマンスがどんどん下がってきます。 効率のよいSQLを発行してもらうためにselect_relatedとprefetch_relatedを使用します。
自分は毎回「このパターンどうするんだっけ...」と忘れてしまうので、パターン集を作成しました。
以下のような人向けです。
- モデルが複雑になってくると混乱して、クエリ削減実装の手が止まってしまう。
- select_related/prefetch_relatedの基本的な使用方法と目的は理解している。
- SQLを最低限理解している(INNER JOIN, OUTER JOIN, WHERE, IN あたりの基本構文)
サンプルは全てdjango shellで実行しており、データ作成コードも乗せているので、すぐに試すことができます。
参考リンク
本記事は公式ドキュメントの例を元に、補足を追加した内容です。
環境
| バージョン | |
|---|---|
| MacOS Ventura | 13.5.2 |
| Python3 | 3.11.4 |
| Django | 5.0.1 |
Djangoの環境を構築する方法は以下を参考にしてください。
事前準備: モデルの作成とデータ投入
以下のドキュメントで出されている例を少し改変しています。
QuerySet API リファレンス | Django ドキュメント | Django
ピザ、トッピング、レストランのモデルです。
- ピザとトッピングは多:多の関係。
- レストランはpizzasフィールドでピザと多:多の関係にあります。(提供するピザ全て)
- レストランはbest_pizzaフィールドでピザと多:1の関係にあります。(一番人気のピザ)
- この時、ピザが親です.
from django.db import models

class Country(models.Model):
    name = models.CharField(max_length=256)
    def __str__(self):
        return self.name

class Topping(models.Model):
    name = models.CharField(max_length=256)
    def __str__(self):
        return self.name

class Pizza(models.Model):
    name = models.CharField(max_length=256)
    country = models.ForeignKey(
        Country,
        related_name='pizza',
        null=True,
        on_delete=models.CASCADE)
    toppings = models.ManyToManyField(Topping)
    def __str__(self):
        return self.name

class Restaurant(models.Model):
    name = models.CharField(max_length=256)  # 追加
    pizzas = models.ManyToManyField(Pizza, related_name='restaurants')
    best_pizza = models.ForeignKey(
        Pizza,
        related_name='championed_by',
        on_delete=models.CASCADE)
    def __str__(self):
        return self.name
マイグレーションします。
(env) $ python manage.py makemigrations
(env) $ python manage.py migrate
データ投入したいので、django shellに入ります。
(env) $ python manage.py shell
シェル内部で以下のコードを実行します。
from app.models import Topping, Pizza, Restaurant, Country

i = Country.objects.create(name='イタリア')

Topping.objects.create(name='トマト')
Topping.objects.create(name='ピクルス')
Topping.objects.create(name='ベーコン')
Topping.objects.create(name='パイナップル')
Topping.objects.create(name='チーズ')
Topping.objects.create(name='焼き魚')

pizza_A = Pizza.objects.create(name='ピザA')
pizza_A.toppings.set(Topping.objects.filter(name__in=['トマト', 'ピクルス', 'ベーコン']))
pizza_A.country = i
pizza_A.save()
pizza_B = Pizza.objects.create(name='ピザB')
pizza_B.toppings.set(Topping.objects.filter(name__in=['トマト', 'ピクルス', 'パイナップル', 'チーズ']))
pizza_C = Pizza.objects.create(name='ピザC')
pizza_C.toppings.set(Topping.objects.filter(name__in=['トマト', '焼き魚']))

restaurant_1 = Restaurant.objects.create(name='レストラン1', best_pizza=pizza_A)
restaurant_1.pizzas.set(Pizza.objects.filter(name__in=['ピザA', 'ピザB']))
restaurant_2 = Restaurant.objects.create(name='レストラン2', best_pizza=pizza_C)
restaurant_2.pizzas.set(Pizza.objects.filter(name__in=['ピザA', 'ピザC']))
No.0 発行されたSQLを確認する
通常SQLの発行はdjango-debug-toolbarを導入したり、logから確認することが多いと思います。 今回はdjango shellだけで完結させるので、django.db.connection.queriesを確認します。 ここに発行されたSQLの履歴が入っています。
django shellへの入り方を再掲します。
(env) $ python manage.py shell
また、発行されたSQL部分のみを確認したいので、以下のヘルパー関数を定義しておきます。(django shellに貼り付ければOKです)
from django.db import reset_queries, connection


def f(q):
    for qt in q:
        print(qt['sql'])

# クエリ確認
f(connection.queries)
# リセット
reset_queries()
以降、全てdjango shell内部で実行しています。
No.1 select_relatedで親を取る
レストラン: 一番人気のピザは多:1の関係です。 レストラン(子)から検索すると、一番人気のピザ(親)は1つにさだまります。
素の状態だとレストランを取得するクエリに加え、取得されたレストランの数だけ一番人気のピザを取るクエリが発行されてしまいます。
>>> for restaurant in Restaurant.objects.all():
        print(f'{restaurant.name}店の一番人気のピザは{restaurant.best_pizza.name}')

レストラン1店の一番人気のピザはピザA
レストラン2店の一番人気のピザはピザC
>>> f(connection.queries)
SELECT "app_restaurant"."id", "app_restaurant"."name", "app_restaurant"."best_pizza_id" FROM "app_restaurant"
SELECT "app_pizza"."id", "app_pizza"."name" FROM "app_pizza" WHERE "app_pizza"."id" = 1 LIMIT 21
SELECT "app_pizza"."id", "app_pizza"."name" FROM "app_pizza" WHERE "app_pizza"."id" = 3 LIMIT 21
このような場合、SQLでは親を結合して取得します。 DjangoのORMでは、select_relatedによって結合が可能です。
発行されたSQLを確認すると、確かにINNER JOINされており、クエリ発行数は1件となっています。やりました。
>>> reset_queries()  # 初期化しておきます.

>>> for restaurant in Restaurant.objects.select_related('best_pizza').all():
        print(f'{restaurant.name}店の一番人気のピザは{restaurant.best_pizza.name}')

レストラン1店の一番人気のピザはピザA
レストラン2店の一番人気のピザはピザC
>>> f(connection.queries)
SELECT "app_restaurant"."id", "app_restaurant"."name", "app_restaurant"."best_pizza_id", "app_pizza"."id", "app_pizza"."name", "app_pizza"."country_id" FROM "app_restaurant" INNER JOIN "app_pizza" ON ("app_restaurant"."best_pizza_id" = "app_pizza"."id")
No.2 select_relatedで親の親を取る
ダブルアンダースコアによって、親の親の...と辿ることができます。 後半は、LEFT OUTER JOINとなっていることに注意してください。(CountryはピザAにだけ設定しています。)
for restaurant in Restaurant.objects.select_related('best_pizza__country').all():
    print(f'{restaurant.name}店の一番人気のピザは{restaurant.best_pizza.name}({restaurant.best_pizza.country})')

レストラン1店の一番人気のピザはピザA(イタリア)
レストラン2店の一番人気のピザはピザC(None)
>>> f(connection.queries)
SELECT "app_restaurant"."id", "app_restaurant"."name", "app_restaurant"."best_pizza_id", "app_pizza"."id", "app_pizza"."name", "app_pizza"."country_id", "app_country"."id", "app_country"."name" FROM "app_restaurant" INNER JOIN "app_pizza" ON ("app_restaurant"."best_pizza_id" = "app_pizza"."id") LEFT OUTER JOIN "app_country" ON ("app_pizza"."country_id" = "app_country"."id")
ところで、以下のようなコードを書く必要はありません。 親の親の親...と辿る時は、一番遠い親を指定すれば良いです。
ダブルアンダースコアで指定すれば、その途中のテーブルもきちんと結合されます。
# 冗長な例. best_pizzaの指定は不要.
select_related('best_pizza', 'best_pizza__country')
No.3 prefetch_relatedで複数件の多を取る
よく解説されている基本の形です。
ピザとトッピングは多:多の関係です。ピザをベースにして取得します。
取得したそれぞれのピザの、トッピングも全て取得したい というケースを考えます。 以下のようにアクセスするとピザを取得するクエリ(1つめ)に加え、取得したピザの数だけ、そのピザに紐つくトッピングを取得するクエリが発行されてしまいます。
f(connection.queries)

reset_queries()
for pizza in Pizza.objects.all():
    print(f'{pizza.name}', ','.join([t.name for t in pizza.toppings.all()]))

ピザA トマト,ピクルス,ベーコン
ピザB トマト,ピクルス,パイナップル,チーズ
ピザC トマト,焼き魚
>>> f(connection.queries)
SELECT "app_pizza"."id", "app_pizza"."name", "app_pizza"."country_id" FROM "app_pizza"
SELECT "app_topping"."id", "app_topping"."name" FROM "app_topping" INNER JOIN "app_pizza_toppings" ON ("app_topping"."id" = "app_pizza_toppings"."topping_id") WHERE "app_pizza_toppings"."pizza_id" = 1
SELECT "app_topping"."id", "app_topping"."name" FROM "app_topping" INNER JOIN "app_pizza_toppings" ON ("app_topping"."id" = "app_pizza_toppings"."topping_id") WHERE "app_pizza_toppings"."pizza_id" = 2
SELECT "app_topping"."id", "app_topping"."name" FROM "app_topping" INNER JOIN "app_pizza_toppings" ON ("app_topping"."id" = "app_pizza_toppings"."topping_id") WHERE "app_pizza_toppings"."pizza_id" = 3
このようなケースでは、SQLとやや異なる方法を取ります。
prefetch_relatedによってトッピングをあらかじめ別のクエリで取得し、Pythonコードによって結合します.
prefetch_relatedはキャッシュ機能(Python側の機能)だと意識すると、理解しやすいと自分は思います。
では実際にクエリを見てみます。
>>> reset_queries()
>>> for pizza in Pizza.objects.prefetch_related('toppings').all():
        print(f'{pizza.name}', ','.join([t.name for t in pizza.toppings.all()]))

ピザA トマト,ピクルス,ベーコン
ピザB トマト,ピクルス,パイナップル,チーズ
ピザC トマト,焼き魚
>>> f(connection.queries)
SELECT "app_pizza"."id", "app_pizza"."name", "app_pizza"."country_id" FROM "app_pizza"
SELECT ("app_pizza_toppings"."pizza_id") AS "_prefetch_related_val_pizza_id", "app_topping"."id", "app_topping"."name" FROM "app_topping" INNER JOIN "app_pizza_toppings" ON ("app_topping"."id" = "app_pizza_toppings"."topping_id") WHERE "app_pizza_toppings"."pizza_id" IN (1, 2, 3)
1つめのクエリでピザ(idが1,2,3)を取得した後に、2つめのクエリが発行されています。
ピザのIDをIN句で全て指定し、必要になるトッピングを全部あらかじめ取得するクエリです。 このクエリの結果をキャッシュしておき、上記のprintで必要になった時に利用しているイメージです。
表からは見えませんが、Pythonのコードによりキャッシュから該当部分を見つけています。
(補足) 上記の説明のソースはこちら。 QuerySet API リファレンス | Django ドキュメント | Django
No.4 Prefetchオブジェクトで多をfilter
prefetch_relatedは上記のようにキャッシュする仕組みです。
なので、キャッシュしたクエリとは異なるパターンでアクセスすると、むしろprefetch_relatedの分だけクエリが増えて無駄になります
以下の例は、アクセス時にfilterを使っています。この場合、prefetchした結果は利用されず再度SQLが発行されます。
- prefetch_relatedではallを指定.
- アクセス時にはfilterを指定.
for pizza in Pizza.objects.prefetch_related('toppings').all():
    print(f'{pizza.name}', ','.join([t.name for t in pizza.toppings.filter(id__gte=3)]))

ピザA ベーコン
ピザB パイナップル,チーズ
ピザC 焼き魚
>>> f(connection.queries)
SELECT "app_pizza"."id", "app_pizza"."name", "app_pizza"."country_id" FROM "app_pizza"
SELECT ("app_pizza_toppings"."pizza_id") AS "_prefetch_related_val_pizza_id", "app_topping"."id", "app_topping"."name" FROM "app_topping" INNER JOIN "app_pizza_toppings" ON ("app_topping"."id" = "app_pizza_toppings"."topping_id") WHERE "app_pizza_toppings"."pizza_id" IN (1, 2, 3)
SELECT "app_topping"."id", "app_topping"."name" FROM "app_topping" INNER JOIN "app_pizza_toppings" ON ("app_topping"."id" = "app_pizza_toppings"."topping_id") WHERE ("app_pizza_toppings"."pizza_id" = 1 AND "app_topping"."id" >= 3)
SELECT "app_topping"."id", "app_topping"."name" FROM "app_topping" INNER JOIN "app_pizza_toppings" ON ("app_topping"."id" = "app_pizza_toppings"."topping_id") WHERE ("app_pizza_toppings"."pizza_id" = 2 AND "app_topping"."id" >= 3)
SELECT "app_topping"."id", "app_topping"."name" FROM "app_topping" INNER JOIN "app_pizza_toppings" ON ("app_topping"."id" = "app_pizza_toppings"."topping_id") WHERE ("app_pizza_toppings"."pizza_id" = 3 AND "app_topping"."id" >= 3)
prefetchする子をフィルターする時は、Prefetchオブジェクトで指定します。
toppings側は、単にallを指定していますがきちんとフィルタされています。 この書き方は、allの結果を上書きしてしまうようなイメージです。
from django.db.models import Prefetch

>>> reset_queries()
>>> for pizza in Pizza.objects.prefetch_related(Prefetch('toppings', queryset=Topping.objects.filter(id__gte=3))):
            print(f'{pizza.name}', ','.join([t.name for t in pizza.toppings.all()]))

ピザA ベーコン
ピザB パイナップル,チーズ
ピザC 焼き魚
>>> f(connection.queries)
SELECT "app_pizza"."id", "app_pizza"."name", "app_pizza"."country_id" FROM "app_pizza"
SELECT ("app_pizza_toppings"."pizza_id") AS "_prefetch_related_val_pizza_id", "app_topping"."id", "app_topping"."name" FROM "app_topping" INNER JOIN "app_pizza_toppings" ON ("app_topping"."id" = "app_pizza_toppings"."topping_id") WHERE ("app_topping"."id" >= 3 AND "app_pizza_toppings"."pizza_id" IN (1, 2, 3))
to_attr属性を指定することで、Prefetchオブジェクトでカスタムしたキャッシュに明示的にアクセスできるので、こちらの記述方法がおすすめです。
>>> for pizza in Pizza.objects.prefetch_related(Prefetch('toppings', queryset=Topping.objects.filter(id__gte=3), to_attr='filtered_toppings')):
            print(f'{pizza.name}', ','.join([t.name for t in pizza.filtered_toppings]))
No.5 prefetch_relatedで2つ先のリレーション: ManyToMany-ManyToMany
ダブルアンダースコアで繋ぐことで指定できます。
- レストランをベースに、提供するピザとそのトッピングを全て取得する。
- レストラン↔️ピザ↔️トッピング
- レストランに紐つく全てのピザを取得する。
- ピザに紐つく全てのトッピングを取得する。
- レストランに紐つく全てのピザを取得する。
for restaurant in Restaurant.objects.prefetch_related('pizzas__toppings').all():
    print(f'{restaurant.name}店のピザ一覧')
    for pizza in restaurant.pizzas.all():
        print(f'\t{pizza.name}', ','.join([t.name for t in pizza.toppings.all()]))

レストラン1店のピザ一覧
        ピザA トマト,ピクルス,ベーコン
        ピザB トマト,ピクルス,パイナップル,チーズ
レストラン2店のピザ一覧
        ピザA トマト,ピクルス,ベーコン
        ピザC トマト,焼き魚
- prefetch_relatedなしなら各レストラン、各ピザごとにクエリが発生します。
- prefetch_relatedで以下の3つのクエリにまとまります。
- レストラン一覧の取得
- レストランのIDをIN句で指定し、対応するピザを全て取得。
- ピザのIDをIN句で指定し、対応するトッピングを全て取得。
>>> f(connection.queries)
SELECT "app_restaurant"."id", "app_restaurant"."name", "app_restaurant"."best_pizza_id" FROM "app_restaurant"
SELECT ("app_restaurant_pizzas"."restaurant_id") AS "_prefetch_related_val_restaurant_id", "app_pizza"."id", "app_pizza"."name", "app_pizza"."country_id" FROM "app_pizza" INNER JOIN "app_restaurant_pizzas" ON ("app_pizza"."id" = "app_restaurant_pizzas"."pizza_id") WHERE "app_restaurant_pizzas"."restaurant_id" IN (1, 2)
SELECT ("app_pizza_toppings"."pizza_id") AS "_prefetch_related_val_pizza_id", "app_topping"."id", "app_topping"."name" FROM "app_topping" INNER JOIN "app_pizza_toppings" ON ("app_topping"."id" = "app_pizza_toppings"."topping_id") WHERE "app_pizza_toppings"."pizza_id" IN (1, 2, 3)
No.6 prefetch_relatedで2つ先のリレーション: ForeignKey-ManyToMany
※次のNo.7の劣化版です
No.5と同じく、ダブルアンダースコアで繋ぐことができます。FKで結合するモデルが間にあっても問題ありません。
- レストラン️←一番人気のピザ↔️トッピング
- レストランにFKで紐つく一番人気のピザ
- ピザに紐つく全てのトッピング取得
for restaurant in Restaurant.objects.prefetch_related('best_pizza__toppings').all():
    print(f'{restaurant.name}店の一番人気のピザ')
    print(f'\t{restaurant.best_pizza.name}', ','.join([t.name for t in restaurant.best_pizza.toppings.all()]))

レストラン1店の一番人気のピザ
        ピザA トマト,ピクルス,ベーコン
レストラン2店の一番人気のピザ
        ピザC トマト,焼き魚
- prefetch_relatedなしなら各ピザごとにクエリが発生します。
- prefetch_relatedで3つのクエリにまとめることができます。
- レストラン一覧の取得
- レストランのIDをIN句で指定し、対応する一番人気のピザを取得(FKなので1件のみ)。
- ピザのIDをIN句で指定し、対応するトッピングを全て取得。
>>> f(connection.queries)
SELECT "app_restaurant"."id", "app_restaurant"."name", "app_restaurant"."best_pizza_id" FROM "app_restaurant"
SELECT "app_pizza"."id", "app_pizza"."name", "app_pizza"."country_id" FROM "app_pizza" WHERE "app_pizza"."id" IN (1, 3)
SELECT ("app_pizza_toppings"."pizza_id") AS "_prefetch_related_val_pizza_id", "app_topping"."id", "app_topping"."name" FROM "app_topping" INNER JOIN "app_pizza_toppings" ON ("app_topping"."id" = "app_pizza_toppings"."topping_id") WHERE "app_pizza_toppings"."pizza_id" IN (1, 3)
No.7 prefetch_relatedで2つ先のリレーション: ForeignKey-ManyToMany + select_related
No.6の改善版です。ForeignKeyの部分は、prefetchよりselect_relatedを使ってSQLレベルで効率化する方が優れています。
主クエリ(select_relatedの"後"に事前読み込み(prefetch)が走るのをイメージすると分かりやすいです。
for restaurant in Restaurant.objects.select_related('best_pizza').prefetch_related('best_pizza__toppings').all():
    print(f'{restaurant.name}店の一番人気のピザ')
    print(f'\t{restaurant.best_pizza.name}', ','.join([t.name for t in restaurant.best_pizza.toppings.all()]))

レストラン1店の一番人気のピザ
        ピザA トマト,ピクルス,ベーコン
レストラン2店の一番人気のピザ
        ピザC トマト,焼き魚
- 2つのクエリにまとめることができます。
- レストラン一覧 + 一番人気のピザ(FK)を同時に取得
- ピザのIDをIN句で指定し、対応するトッピングを全て取得。
>>> f(connection.queries)
SELECT "app_restaurant"."id", "app_restaurant"."name", "app_restaurant"."best_pizza_id", "app_pizza"."id", "app_pizza"."name", "app_pizza"."country_id" FROM "app_restaurant" INNER JOIN "app_pizza" ON ("app_restaurant"."best_pizza_id" = "app_pizza"."id")
SELECT ("app_pizza_toppings"."pizza_id") AS "_prefetch_related_val_pizza_id", "app_topping"."id", "app_topping"."name" FROM "app_topping" INNER JOIN "app_pizza_toppings" ON ("app_topping"."id" = "app_pizza_toppings"."topping_id") WHERE "app_pizza_toppings"."pizza_id" IN (1, 3)
No.8 Prefetchで2つ先のリレーションをorder_byする
- レストラン↔️ピザ↔️トッピング: トッピングをnameの降順にする
- 中間にあるピザもprefetchされている点に注意(No.5をベースに考えます)
>>> for restaurant in Restaurant.objects.prefetch_related(Prefetch('pizzas__toppings', queryset=Topping.objects.order_by('-name'))):
        print(f'{restaurant.name}店のピザ一覧')
        for pizza in restaurant.pizzas.all():
             print(f'\t{pizza.name}', ','.join([t.name for t in pizza.toppings.all()]))

レストラン1店のピザ一覧
        ピザA ベーコン,ピクルス,トマト
        ピザB ピクルス,パイナップル,トマト,チーズ
レストラン2店のピザ一覧
        ピザA ベーコン,ピクルス,トマト
        ピザC 焼き魚,トマト
- ピザIDをINに指定した、トッピング取得クエリにORDER_BYがつきます。
>>> f(connection.queries)
SELECT "app_restaurant"."id", "app_restaurant"."name", "app_restaurant"."best_pizza_id" FROM "app_restaurant"
SELECT ("app_restaurant_pizzas"."restaurant_id") AS "_prefetch_related_val_restaurant_id", "app_pizza"."id", "app_pizza"."name", "app_pizza"."country_id" FROM "app_pizza" INNER JOIN "app_restaurant_pizzas" ON ("app_pizza"."id" = "app_restaurant_pizzas"."pizza_id") WHERE "app_restaurant_pizzas"."restaurant_id" IN (1, 2)
SELECT ("app_pizza_toppings"."pizza_id") AS "_prefetch_related_val_pizza_id", "app_topping"."id", "app_topping"."name" FROM "app_topping" INNER JOIN "app_pizza_toppings" ON ("app_topping"."id" = "app_pizza_toppings"."topping_id") WHERE "app_pizza_toppings"."pizza_id" IN (1, 2, 3) ORDER BY "app_topping"."name" DESC
No.9 prefetch_relatedで2つ先のリレーション: ManyToMany-ForeignKey
No.7は、クエリ対象の直接の関連先がForeignKey、その先がManyToManyでした。 今回は直接の関連先がManyToManyで、その先にForeignKeyで結合したモデルがある場合です。
Pretetchで取得するとき、対象のFKをJOINさせる指示 というイメージが分かりやすいと思います。 Prefetchのquerysetでselect_relatedを使うのがポイントです。
- ピザ↔️レストラン←一番人気のピザ
- ピザ↔️レストラン: prefetchで別クエリにします(ピザIDをIN句指定)
- レストラン←一番人気のピザ: select_relatedでSQLで結合した状態で取得します。
for pizza in Pizza.objects.prefetch_related(Prefetch('restaurants', queryset=Restaurant.objects.select_related('best_pizza'))):
    print(f'{pizza.name}が提供されてるレストラン一覧')
    for restaurant in pizza.restaurants.all():
        print(f'\t{restaurant}の一番人気のピザは: {restaurant.best_pizza.name}')

ピザAが提供されてるレストラン一覧
        レストラン1の一番人気のピザは: ピザA
        レストラン2の一番人気のピザは: ピザC
ピザBが提供されてるレストラン一覧
        レストラン1の一番人気のピザは: ピザA
ピザCが提供されてるレストラン一覧
        レストラン2の一番人気のピザは: ピザC
最初に取得したピザIDをIN句にしてまとめてレストランを一発で取れていることに注目してください。 さらに、それぞれのレストランの最良ピザはSQLの時点で結合できています。
>>> f(connection.queries)
SELECT "app_pizza"."id", "app_pizza"."name", "app_pizza"."country_id" FROM "app_pizza"
SELECT ("app_restaurant_pizzas"."pizza_id") AS "_prefetch_related_val_pizza_id", "app_restaurant"."id", "app_restaurant"."name", "app_restaurant"."best_pizza_id", T4."id", T4."name", T4."country_id" FROM "app_restaurant" INNER JOIN "app_restaurant_pizzas" ON ("app_restaurant"."id" = "app_restaurant_pizzas"."restaurant_id") INNER JOIN "app_pizza" T4 ON ("app_restaurant"."best_pizza_id" = T4."id") WHERE "app_restaurant_pizzas"."pizza_id" IN (1, 2, 3)
省略しますが、prefetchなどをつけない状態だと以下のようにクエリがたくさん発行されます。 - ピザ一覧を取得し、それぞれのピザIDに対してレストランを1件ずつクエリで取得。 - そのレストランの最良ピザIDをクエリにして、再度ピザを取得する。
No.10 to_attrで複数の絞り込みをする
- 同じ対象を複数のパターンで同時に絞って使いたいケース。
- レストラン↔️ピザ で、ピザを複数の方法で絞る
- あるレストランにひもつく、イタリアのピザ一覧 と 全てのピザ一覧を同時に取得する。
余談ですが、italy_pizzaとall_pizzaを定義した時点ではSQLは発行されていないという点も大事です。 QuerySetは遅延評価なので、実際の値を取得するまで発行されません。
italy_pizza = Pizza.objects.filter(country=italy)
all_pizza = Pizza.objects.all()
for restaurant in Restaurant.objects.prefetch_related(Prefetch('pizzas', queryset=italy_pizza, to_attr='italy'), Prefetch('pizzas', queryset=all_pizza, to_attr='all_pizzas')):
    print(f'{restaurant.name}店')
    print('\t', ','.join([pizza.name for pizza in restaurant.italy]))
    print('\t', ','.join([pizza.name for pizza in restaurant.all_pizzas]))

レストラン1店
         ピザA
         ピザA,ピザB
レストラン2店
         ピザA
         ピザA,ピザC
Prefetchを指定した数だけ、SQLが増えます。
>>> f(connection.queries)
SELECT "app_restaurant"."id", "app_restaurant"."name", "app_restaurant"."best_pizza_id" FROM "app_restaurant"
SELECT ("app_restaurant_pizzas"."restaurant_id") AS "_prefetch_related_val_restaurant_id", "app_pizza"."id", "app_pizza"."name", "app_pizza"."country_id" FROM "app_pizza" INNER JOIN "app_restaurant_pizzas" ON ("app_pizza"."id" = "app_restaurant_pizzas"."pizza_id") WHERE ("app_pizza"."country_id" = 1 AND "app_restaurant_pizzas"."restaurant_id" IN (1, 2))
SELECT ("app_restaurant_pizzas"."restaurant_id") AS "_prefetch_related_val_restaurant_id", "app_pizza"."id", "app_pizza"."name", "app_pizza"."country_id" FROM "app_pizza" INNER JOIN "app_restaurant_pizzas" ON ("app_pizza"."id" = "app_restaurant_pizzas"."pizza_id") WHERE "app_restaurant_pizzas"."restaurant_id" IN (1, 2)
No.11 1つ先、2つ先のリレーションをそれぞれ条件付きでPrefetch(ManyToMany-ManyToMany)
- 1つ先のManyToManyをfilter条件付きでprefetchし、2つ先もfilterして取得するパターン.
- to_attrで名付けることで、2つ先をダブルアンダースコアで指定可能にします。
- 以下これまで記述した類似パターン
- No.5: all(1つ先)、all(2つ先)だった。
- No.8: all(1つ先)、2つ先をorder_by
- No.9: all(1つ先)、2つ先はselect_related
2つ先(トッピング)を取得する時に、すでにフィルタされた1つ先(ピザ)に関連するものだけ取得したい、というのがポイントです。
italy_pizza = Pizza.objects.filter(country=italy)
for restaurant in Restaurant.objects.prefetch_related(Prefetch('pizzas', queryset=italy_pizza, to_attr='italy'), Prefetch('italy__toppings', queryset=Topping.objects.filter(id__lte=2), to_attr='topping_2')):
    print(f'{restaurant.name}店')
    for pizza in restaurant.italy:
        print(f'\t{pizza.name}', ','.join([t.name for t in pizza.topping_2]))

レストラン1店
        ピザA トマト,ピクルス
レストラン2店
        ピザA トマト,ピクルス
一つ先(Pizza)がレストランの取得結果とcountry=1でフィルタされている。 その結果のピザIDを3つめのtopping取得時にIN句で使い、id<=2のフィルタも同時に実行している。
>>> f(connection.queries)
SELECT "app_restaurant"."id", "app_restaurant"."name", "app_restaurant"."best_pizza_id" FROM "app_restaurant"
SELECT ("app_restaurant_pizzas"."restaurant_id") AS "_prefetch_related_val_restaurant_id", "app_pizza"."id", "app_pizza"."name", "app_pizza"."country_id" FROM "app_pizza" INNER JOIN "app_restaurant_pizzas" ON ("app_pizza"."id" = "app_restaurant_pizzas"."pizza_id") WHERE ("app_pizza"."country_id" = 1 AND "app_restaurant_pizzas"."restaurant_id" IN (1, 2))
SELECT ("app_pizza_toppings"."pizza_id") AS "_prefetch_related_val_pizza_id", "app_topping"."id", "app_topping"."name" FROM "app_topping" INNER JOIN "app_pizza_toppings" ON ("app_topping"."id" = "app_pizza_toppings"."topping_id") WHERE ("app_topping"."id" <= 2 AND "app_pizza_toppings"."pizza_id" IN (1))
2つ先をフィルタしないなら以下のように書けば良いです。
>>> for restaurant in Restaurant.objects.prefetch_related(Prefetch('pizzas', queryset=italy_pizza, to_attr='italy'), 'italy__toppings'):
        print(f'{restaurant.name}店')
        for pizza in restaurant.italy:
            print(f'\t{pizza.name}', ','.join([t.name for t in pizza.toppings.all()]))

レストラン1店
        ピザA トマト,ピクルス,ベーコン
レストラン2店
        ピザA トマト,ピクルス,ベーコン
No.12 親ベースで1件の子を取得する
- 子を、親モデル.get(検索条件)するようなケース
- 取得結果は1件でもList形式になり、これはどうしようもないっぽい。
- prefetchで指定し、0番目を取得する。
子側から検索して、関連する親をselect_relatedすることができるならそちらを採用する.
qtatsuの手順書
前書き
この記事は自分のブログ記事からの参照用です。 追記や変更を頻繁にする予定です。
1. Djangoの環境構築
前提
| バージョン | |
|---|---|
| MacOS Ventura | 13.5.2 |
| Python3 | 3.11.4 |
参考リンク
公式ドキュメントです.
- How to install Django | Django documentation | Django
- Writing your first Django app, part 1 | Django documentation | Django
手順
仮想環境の作成
$ python3 -m venv env
$ source env/bin/activate

# 完了確認
(env) $ python --version
Python 3.11.4
以下、仮想環境中で作業します。(env)がついている状態です。
pipのアップデート
(env) $pip install --upgrade pip
Djangoのインストール
(env) $ pip install Django==5.0.1
プロジェクトの立ち上げ
projectというディレクトリを作成して、その中でstartprojectコマンドを実行します。
(env) $ mkdir project
(env) $ cd project
(env) $ django-admin startproject config .
(env) $ ls
config/    manage.py*
.を指定することで、manage.pyが今いるディレクトリ(project)にできるようになります。詳しくは以下のリンクを参考にしてください。
django-admin and manage.py | Django documentation | Django
アプリの追加
(env) $ python manage.py startapp app
設定ファイルのINSTALLED_APPSリストに以下を追記する.
INSTALLED_APPS = [
    'app.apps.AppConfig',   # 追加
    ...省略...
]
マイグレーション
$ python manage.py migrate
完了確認
$ python manage.py runserver 8000
指定したポートにアクセスします。 上記のように実行したのなら http://localhost:8000/ です。
ロケットのページが出ていたら成功です。
【Python】並び順を無視してlistの要素を比較する方法3つ【sort, assertCountEqual, deepdiff】
(※ qiitaに書いた記事の、削る前バージョンです)
【Python】並び順を無視してリストを比較するテスト(DeepDiff) - Qiita
- 結論: deepdiffを使う
- 前書き
- 参考リンク
- 環境
- 文字列のリスト: sortをつかう.
- 辞書のリスト: keyを指定してソートする.
- 辞書のリスト: assertCountEqualを使う.
- valueにリストをもつ辞書のリスト: DeepDiffを使う
- 結論
- まとめ
結論: deepdiffを使う
実現したい条件は以下の二つ.
- 辞書を要素として持つリストがあり、「同じリスト」かを比べたい.
- ただし並び順は異なっていても良いこととする。
- 辞書のあるvalue(下例では
spells)もリストとなっている。- こちらの要素も並び順は異なっていても良いこととする。
>>> dict_in_list1
[
    {'name': 'Reimu', 'spells': ['Musouhuin', 'niju-kekkai']},
    {'name': 'Marisa', 'spells': ['non-directional laser', 'star-dust reverie']},
    {'name': 'Alice', 'spells': ['hourai-doll', 'shanghai-doll']}
]

>>> dict_in_list2
[
    {'name': 'Marisa', 'spells': ['star-dust reverie', 'non-directional laser']},
    {'name': 'Reimu', 'spells': ['Musouhuin', 'niju-kekkai']},
    {'name': 'Alice', 'spells': ['hourai-doll', 'shanghai-doll']}
]
DeepDiffを使うと、以下のようにして同じデータであるかを比較できる.
pytest
assert not DeepDiff(dict_in_list1, dict_in_list2, ignore_order=True)
unittest
self.assertEqual(DeepDiff(dict_in_list1, dict_in_list2, ignore_order=True), {})
前書き
テストコードを書いていると、assert部分が巨大になってしまい、見通しや目的の把握が難しくなってくることがあります。
もちろん、なるべくテストを小さい単位で書く、クリティカルな部分のみチェックするなどの工夫をすることが第一ではあります。
しかし、APIの返り値やバッチ処理の結果などを、そのまま確かめたい..という以下のようなケースもあると思います.
- ある程度のデータの組みが揃うと意味の通るデータになるもの.
- テストを書きながら開発/リファクタしており、現在の返り値が壊れていないことを、リファクタ中に確かめるテストをサッと用意したい.
このようなケースでは、オブジェクトをそのまま比較したくなりますが、リストの要素を並び順を無視して比較するときは、要素の型によってとても難しくなってしまいます。
今回は、DeepDiffの他、sortする方法やassertCoutEqualメソッドを用いた方法も紹介したいと思います.
参考リンク
GitHub - seperman/deepdiff: Deep Difference and search of any Python object/data.
unittest --- ユニットテストフレームワーク — Python 3.10.0b2 ドキュメント
環境
| バージョン | |
|---|---|
| MacOS Big Sur | 11.6 |
| Python3 | 3.9.1 |
| deepdiff | 5.7.0 |
文字列のリスト: sortをつかう.
同僚の方はsortをよく使うとお聞きしました。
見た目にも何をやっているか分かりやすく、シンプルにかけるため、可能な限りこちらを使うべきだと思います .
文字列など、ソートできる(つまり<演算子で大小を比べることができる、__lt__が定義されている)場合は簡単です.
以下のふたつのリストを比較します。
含まれている要素は同じですが、順番が異なっていることに注意します。(同じ結果だと判定したい.)
names1 = ["Reimu", "Alice", "Marisa"]
names2 = ["Reimu", "Marisa", "Alice"]
リストの比較は要素を頭から順番に比較するので、そのままではダメです.
>>> names1 == names2
False
ソートします。
>>> sorted(names1) == sorted(names2)
True
辞書のリスト: keyを指定してソートする.
今度の例は辞書(dict)がリストの要素として並んでいます。
先ほどと似ていますが、今回はそのままではソートできません。
今回の例も、含まれている要素は同じですが、順番が異なっていることに注意します。(同じ結果だと判定したい.)
names1 = [
    {"name": "Reimu"},
    {"name": "Marisa"},
    {"name": "Alice"},
]
names2 = [
    {"name": "Alice"},
    {"name": "Reimu"},
    {"name": "Marisa"},
]
まず、そのまま比較したときはFalseとなります。(並び順は異なっていてもよいので, 実際はTrueだと判定したい)
>>> names1 == names2
False
dict同士は<の挙動が定義されていないのでsortできません。
>>> sorted(names1)

TypeError: '<' not supported between instances of 'dict' and 'dict'
この場合、それぞれのdictが必ずname属性をもち、重複しないならば、keyを指定することでソートすることが可能です.
keyを指定すると、key: nameのvalueの値で比較してソートすることになります。
>>> sorted(names1, key=lambda x: x["name"])
[
    {'name': 'Alice'},
    {'name': 'Marisa'},
    {'name': 'Reimu'}
]
keyに渡した関数lambdaの、引数xに各dictが順番に渡されます。そして、dictのnameキーにあたるvalueが取り出されて比較に使われるイメージです。
結果、順番に関係なく同じ要素を含んでいることが確かめられました.
>>> sorted(names1, key=lambda x: x["name"]) == sorted(names2, key=lambda x: x["name"])
True
keyで取得する値はタプルになっても良いので、nameキーだけではソートできない場合も対応できると思います(未検証)。
しかし、テストコードでの使用を想定している場合、結果の比較のために複雑なソート条件を書くことは慎重に考えた方が良いと思います。
辞書のリスト: assertCountEqualを使う.
このようなケースで、Python標準のツールにはもう一つ強力なものがあります。
unittestモジュールで、TestCaseクラスに実装されているassertヘルパーメソッドのひとつ、assertCountEqualです。
名前の印象とはかなり異なりますが、「順番によらず同じ要素が同じ数だけある」ことを検証できるassertメソッドとなっています。
unittest --- ユニットテストフレームワーク — Python 3.10.0b2 ドキュメント
unittestを使っている場合には、self.assertCountEqualを呼び出せば良いだけですので、今回はpytestなどからも使用できるよう、TestCaseをインスタンス化して使う手順を示します.
比較するのは、先ほどkey指定してソートしていたdict in listです。
names1 = [
    {"name": "Reimu"},
    {"name": "Marisa"},
    {"name": "Alice"},
]
names2 = [
    {"name": "Alice"},
    {"name": "Reimu"},
    {"name": "Marisa"},
]
>>> from unittest import TestCase
>>> case = TestCase()
>>> case.assertCountEqual(names1, names2)  # OK!!
とても楽ですね!
公式ドキュメントに仕組みについて説明がありますが、ほとんどの組み込み型は何も意識せずに比較できます。自分の場合も、大抵の場合はsortとassertCountEqualのどちらかで事足りています。
assertEqual() メソッドは、同じ型のオブジェクトの等価性確認のために、型ごとに特有のメソッドにディスパッチします。これらのメソッドは、ほとんどの組み込み型用のメソッドは既に実装されています。さらに、 addTypeEqualityFunc() を使う事で新たなメソッドを登録することができます.
難点は今回の目的では、メソッド名称が不自然になる 点かと思います。
この名前は、仕組み自体をとてもよく表しています。出現したオブジェクトを、(collectionモジュールの)Counterを使って数え上げているためです。
なので「順番を気にせずリストを比較したい!」というのは、可能ではあるのですが本来の使い方とはちょっとずれているのかな、と思います。
多分ですが、assertCountEqualの本来の使い方は、下のようなケースだと思います。
>>> fruits1 = ["りんご", "みかん", "みかん", "りんご", "りんご"]
>>> fruits2 = ["りんご", "みかん", "みかん", "りんご", "みかん"]
>>> case.assertCountEqual(fruits1, fruits2)

AssertionError: Element counts were not equal:
First has 3, Second has 2:  'りんご'
First has 2, Second has 3:  'みかん'
うーん、エラーメッセージも分かりやすいですね...!!!
valueにリストをもつ辞書のリスト: DeepDiffを使う
リストの比較は、大抵はsortedとassertCountEqualで可能かと思います。
というより、これ以上複雑な比較をするならそもそもテストの構成や比較の仕方を考え直した方がいいかと思います。
しかし、冒頭にも書きましたが、APIの返り値などを「実際に叩いてみて」とった値をそのままテストに使いたいというシーンが時々あります。
使い捨てのスクリプトをデグレしないように修正するときの一時的なテストコードを作る時などには、自分はこのようなassertを書きたくなります。
この場合、「リストの要素が辞書」かつ、「辞書のvalueにもリスト」があり、そのリストの順番も無視して要素が一致しているか確認したいケースがあります。
例を出すと、こんな感じです。
>>> dict_in_list1
[
    {'name': 'Reimu', 'spells': ['Musouhuin', 'niju-kekkai']},
    {'name': 'Marisa', 'spells': ['non-directional laser', 'star-dust reverie']},
    {'name': 'Alice', 'spells': ['hourai-doll', 'shanghai-doll']}
]

>>> dict_in_list2
[
    {'name': 'Marisa', 'spells': ['star-dust reverie', 'non-directional laser']},
    {'name': 'Reimu', 'spells': ['Musouhuin', 'niju-kekkai']},
    {'name': 'Alice', 'spells': ['hourai-doll', 'shanghai-doll']}
]
上の2つのリストは、要素であるdictの順番が入れ替わっています。
さらに、name: Marisaの項目を見ると、spells要素はリストなのですが、下に抜き出したように順番が逆になっています。
'spells': ['non-directional laser', 'star-dust reverie']
'spells': ['star-dust reverie', 'non-directional laser']
これも含め、同一の物として判定したいです。
ちなみにassertCountEqualを使うと、以下のように異なる要素だと判定されてしまいます。
>>> case.assertCountEqual(dict_in_list1, dict_in_list2)

AssertionError: Element counts were not equal:
First has 1, Second has 0:  {'name': 'Marisa', 'spells': ['non-directional laser', 'star-dust reverie']}
First has 0, Second has 1:  {'name': 'Marisa', 'spells': ['star-dust reverie', 'non-directional laser']}
このようなケースでも同じオブジェクトだと一発で判定できるサードパーティ製のライブラリがあります。それがdeepdiffです。
本来もっと多機能なのですが、今回はテストという観点のみから記述します.
導入はpipで簡単に行えます.
$ pip install deepdiff
今回のケース(リスト部分の順番を無視して同一かを判定)での使用は、以下のようにignore_order=Trueとしておこないます。
DeepDiff(dict_in_list1, dict_in_list2, ignore_order=True)
{}  # 空のdeepdiff.diff.DeepDiffオブジェクトが返ってくる.
あとは冒頭で示したように、assert文やassertメソッドで判定すればOKです。
なお、DeepDiffは差分がある場合には、どのキーのどの要素が、どんなふうに異なっているかを示してくれます。
>>> dict_in_list3 = [
        {"name": "Marisa", "spells": ["star-dust reverie", "non-directional laser"]},
        {"name": "Reimu", "spells": ["niju-kekkai"]},
    ]

>>> DeepDiff(dict_in_list1, dict_in_list3, ignore_order=True)
{
    'iterable_item_removed': {
        "root[0]['spells'][0]": 'Musouhuin',
        'root[2]': {
            'name': 'Alice',
            'spells': ['hourai-doll', 'shanghai-doll']
         }
     }
}
dict_in_list3で削除された情報が、階層情報とともに表示されました.
結論
- 可能な限りsortedでソートして比較する.
- sort条件が複雑になるなら、assertCountEqualメソッドの使用も検討する.
- もっと難しい状況ではDeepDiffをignore_order=Trueとして使うこともできる.
まとめ
順番によらず、同じ要素を持つリストであるかを検証する方法を3つ紹介しました。
もちろん、そもそも比較しにくいものを比較せずに済むテストが書けるならその方がよいです。あまり乱用すると、返って読み辛いテストになってしまうかもしれません。
しかし特定の文脈では、今回紹介したような方法を試すのも選択肢に入れても良いのではないでしょうか.
他にもいい方法、自分ならこうするよ!などのご意見いただけると嬉しいです。
【Python】コミット差分のみblackで整形する 【darker】
前書き
コードの整形はフォーマッタに任せたいものです。
理想的には、全員が同じスタイルでコードを整形できるようにpre-commitなどを利用してコミット時にフォーマッタを自動実行します。
しかしプロジェクトの途中参加など、導入が難しいケースもあると思います。
今回の自分は、プロジェクトにフォーマッタが導入がされておらず
- せめて自分のコミット分だけはblackで整形したい。
- 共通ライブラリを更新時、ファイル単位ではなく行単位で整形したい。
という状況でした。 根本解決を諦め、次善の方法はないかと調べたところ darkerという、black(とisort)のwrapperライブラリが良さそうでした。
(なお、Darker作者はGitHubのREADMEに、本家のblackにも行単位のフォーマット機能は将来導入されそうだと言及しています.)
darkerについては日本語の情報が少ないようだったので、試してみた内容をまとめておこうと思います。
参考リンク
環境
| バージョン | |
|---|---|
| MacOS Big Sur | 11.6 |
| Python3 | 3.10.2 |
| darker | 1.3.2 |
| black | 21.12b0 |
| Pygments | 2.11.2 |
darkerのインストール
インストール
仮想環境を作ってpip installします。
$ python3.10 -m venv env
$ source env/bin/activate
(env)$ pip install darker
注意: blackのバージョンを下げる必要がある.(2022-02-05) 修正されています.
(2022-03-04)追記: 現在は修正されています。この項目は不要ですが、記録として残しておきます。
2022-02-05 現在、このままだとdarkerを利用できません。
darkerはblackのwrapperなので、darkerをインストールすると最新のblackが一緒に落とされます。しかし、最新のblack(ついにβが取れた22.1.0)はdef find_project_root関数の返り値の型がPathからtupleに変わってしまい、darerは未対応です。
こちらのプルリクで、既にdarkerの作者(akaiholaさん)が修正中のようです。 追記: -> すでに修正されています。
とりあえずは、blackのバージョンをβ版まで落とせば良いです。
(余談ですが、以下のようにして実行するとinstall可能バージョンを見ることができて便利です.(多分正当な方法ではないですが...))
(env)$ pip install black==
............................(省略)...........................
 20.8b1, 21.4b0, 21.4b1, 21.4b2, 21.5b0, 21.5b1, 21.5b2, 21.6b0, 21.7b0, 21.8b0, 21.9b0, 21.10b0, 21.11b0, 21.11b1, 21.12b0, 22.1.0)
ERROR: No matching distribution found for black==
最新の一個前は21.12b0ですので、こちらにダウングレードしておきます。
(env)$ pip install black==21.12b0
Pygmentsで色をつける
もうひと手間加えて、出力結果の見た目をきれいにしておきます。
Pygments を同じ環境にインストールしてあると、darkerは出力結果をカラーにしてくれます。
(env)$ pip install Pygments==2.11.2
特に設定は必要ありません。
darkerの出力結果は、元々このような見た目ですが、
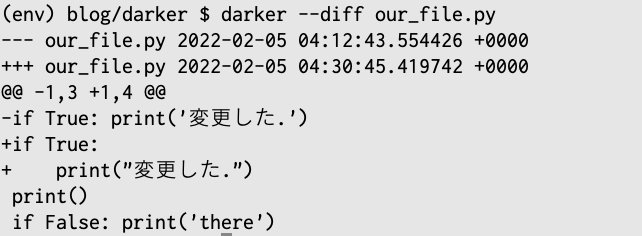
このように変わります。
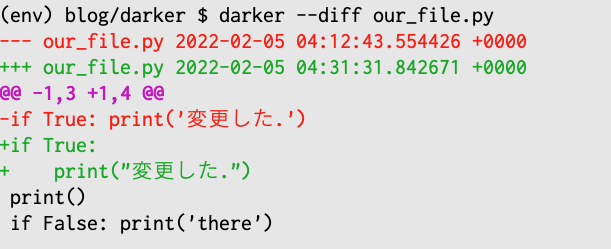
使い方
新規差分を整形
まず、darkerはgit diffを利用するので、ディレクトリをgit 管理下におく必要があります。
適当なディレクトリを作成し、最初のコミットまで済ませておきます。(内容はなんでもOKです.)
$ git init
$ touch README.md
$ git add README.md
$ git commit -m "first"
これでHEADができたので、darkerを利用できます。以下のようなpythonファイル(darker_test.py)を作成します。
(とにかく横に長くしたかっただけなので、適当です)
def format_name_and_age_to_profile(name: str | None, age: int | None, address: str | None): return f"{name} -- {age} -- {address}"
一旦、ここでコミットします. darkerが「コミット差分」に効くことを検証したいからです。
$ git add darker_test.py
$ git commit -m "一つ目の関数"
$ git log --oneline
7e25910 (HEAD -> master) 一つ目の関数
b6bee90 first
では、darker_test.pyにもう一つ記述を加えて以下のようにします。
def format_name_and_age_to_profile(name: str | None, age: int | None, address: str | None): return f"{name} -- {age} -- {address}"

def format_name_and_age_to_profile_version_2(name: str | None, age: int | None, address: str | None): return f"{name} -- {age} -- {address}"  # 2回目のコミット
まだコミットはしないでください! (addまではOKです.)
ここで darkerで修正差分を出力してみます.
今回は以下のように、カレントディレクトリ(.)かファイルを直接指定します。どちらでも結果は変わりません.
$ darker --diff .               # カレントディレクトリ
$ darker --diff darker_test.py  # ファイル指定.
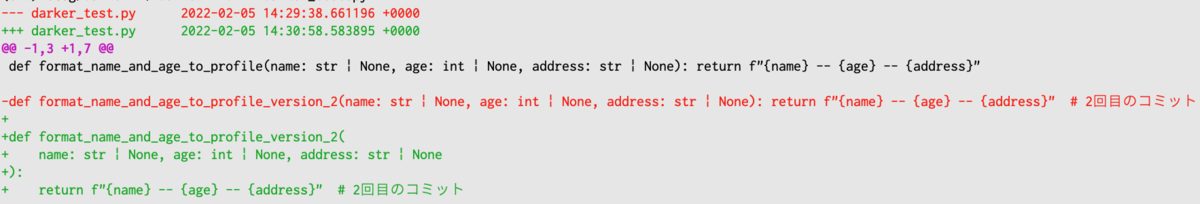
今回の変更分だけが整形されていることがわかります。 最初にコミット済みの、一つ目の関数は整形されていません。
また、この時点では元ファイルは変更されていません。修正をファイルに反映したければ、--diffオプションを外します。
$ darker .
整形後は以下のようになります。二つ目の関数(まだコミットしていない分)だけが、整形されています。
def format_name_and_age_to_profile(name: str | None, age: int | None, address: str | None): return f"{name} -- {age} -- {address}"


def format_name_and_age_to_profile_version_2(
    name: str | None, age: int | None, address: str | None
):
    return f"{name} -- {age} -- {address}"  # 2回目のコミット
では一旦コミットしておきましょう。
$ git add .
$ git commit -m "二つ目の関数(整形済み)"
コミットを指定して整形
darkerはgit-diffを利用しているので、例えばあるコミットからあるコミットまでという範囲を指定し、その時の変更をターゲットに整形が可能です。
先程のコミットログは以下のようになっています。
$ git log --oneline
8de1f64 (HEAD -> master) 二つ目の関数(整形済み)
7e25910 一つ目の関数
b6bee90 first
一つ目の関数は整形できていなかったので、こちらを指定して整形を行います。firstコミット(b6bee90)から7e25910の間の変更なので以下のように指定します。
最後にPATHを指定する必要があるのですが、直接ファイル名(darker_test.py)を指定するか、以下のようにワイルドカードを使う必要がありました。
.(カレントディレクトリ)指定は、なぜかできない仕様のようでした。
$ darker --diff --revision b6bee90..7e25910 * # *.pyやdarker_test.pyでも大丈夫.
またhelpを見ると、コミット間は...(ドット三つ)で区切るように書いてありました。(2つでもできますが、違いは不明です)
結果は、指定したコミット間で記述した一つ目の関数が整形されています。

pre-commitでdarkerを使う
まずpre-commitの導入です。
(env)$ pip install pre-commit
(env)$ pre-commit --version
pre-commit 2.17.0
.pre-commit-config.yamlを Darkerの公式GitHubにある参考例を元に記述します。
blackのバージョンを落としてください (2022-02-06現在. 理由は前述の通り.)
repos:
-   repo: https://github.com/akaihola/darker
    rev: 1.3.2
    hooks:
    -   id: darker
        additional_dependencies: [black==21.12b0]  # 最新blackだと失敗する.
$ pre-commit install
ではdarkerにまた長い名前の関数を1行で書き、実行してみます。
こちらを追記し...
def format_name_and_age_to_profile3(name: str | None, age: int | None, address: str | None): return f"{name} -- {age} -- {address}"
(env)$ git add .
(env)$ git commit
結果、コミットしていない差分のみがフォーマットされているはずです。
そもそも自分だけコード整形することに意味はあるか?
同僚の方にも相談させていただいたのですが、
- そもそも自動フォーマットはレビューの負担軽減のためにやっている.
- チームでコードを統一することが目的.
という指摘をいただきました。
全くその通りで、本当はプロジェクト全体で設定ファイルを共有し、pre-commitでblack/isort/flake8/mypyあたりをかけることが自動フォーマットの目的に即していると思います。
自分の場合、
- 既存のpythonコードはフォーマッタなどを適応していない。また、クオートなどのスタイルはバラバラ。
- 新規にコードを追加するのは基本的に自分だけ。レビューは受ける.
- 既存のpythonスクリプトも、自前のutility関数が大量に入ったライブラリもそこそこの量がある。
という状況でした。
そのため、自分自身が書いた範囲のコードを読みやすくしたく、書くときには余計なことを考えなくて済むようにやはりフォーマッタは欲しいと思いました。そのため、本来の目的とは少し離れてしまうことを念頭に置き、一時しのぎ的にdarkerを利用しようと思っています。
もちろん、これは根本解決にはならない、ということを常に忘れないようにしたいと思います。
まとめ
- 可能ならプロジェクト立ち上げ時にpre-commitを設定しておいた方がよい。
- 自動フォーマットの目的は何か見失わないようにする。
- それでもコミット差分だけをフォーマットしたいなら、darkerは選択肢に入ってくる。
ご意見、ご指摘などいただけると嬉しいです:pray:
【Python】テスト時にデフォルト引数の値を差し替える
- 前書き
- 参考リンク
- 環境
- 前置き: テスト対象 なんどもリトライする関数
- テスト: 失敗するテストに時間がかかる
- 方法0. テストを分ける
- 方法1. __defaults__を書き換える
- 方法2. partialを使ってデフォルト引数を書き換える
- まとめ
前書き
この記事は
Calendar for JSL(日本システム技研) | Advent Calendar 2021 - Qiita
の12/13(月)の記事です。
Pythonのテストコードを書く時に、デフォルト引数を変更したいケースがあります。
たとえば失敗時にリトライを繰り返したり、ループを何周もする関数の挙動を確認する際には1,2回繰り返せば十分です。
関数呼び出し時に値を指定している場合は簡単にmockできますが、デフォルト引数の値をそのまま利用するケース、つまり関数呼び出し時に引数を指定していない場合には難しいです。
この記事ではその様なケースへの対処法を紹介しますが、「もっといい方法があるよ!」とか「そもそもこうした方がいいよ!」というご意見があれば、コメントでアドバイスいただけると嬉しいです。
参考リンク
unittest --- ユニットテストフレームワーク — Python 3.10.0b2 ドキュメント
unittest.mock --- モックオブジェクトライブラリ — Python 3.10.0b2 ドキュメント
functools --- 高階関数と呼び出し可能オブジェクトの操作 — Python 3.10.0b2 ドキュメント
環境
| バージョン | |
|---|---|
| MacOS Big Sur | 11.6 |
| Python3 | 3.9.1 |
| requests | 2.25.1 |
前置き: テスト対象 なんどもリトライする関数
今回テストする関数を見ていきます。
あくまでサンプルなので、実用コードとしては不十分です。お気をつけください。
main.py
import requests
from requests.exceptions import ConnectionError


def request_with_retry(url, retry=10):
    for i in range(retry):
        try:
            result = requests.get(url)
        except ConnectionError as e:
            print(f"失敗{i}回目")
            time.sleep(1)
        else:
            return result.content


def show_result(url):
    content = request_with_retry(url)  # デフォルトのretry数で実行
    if content:
        return f"------- {content} ----------"
    else:
        return '結果を取得できなかった'
requests_with_retry関数
- 渡したURLにGETリクエストを投げ、結果のテキストを返す関数です。失敗したらNoneが返ります。
- 対象URLに接続できなくても、retry引数で渡した回数だけリトライを試みます。
- デフォルト値は10回です。
show_result
- テスト対象の関数です。
- 内部で
requests_with_retry関数をリトライ数を指定せず callし、その結果を利用しています。
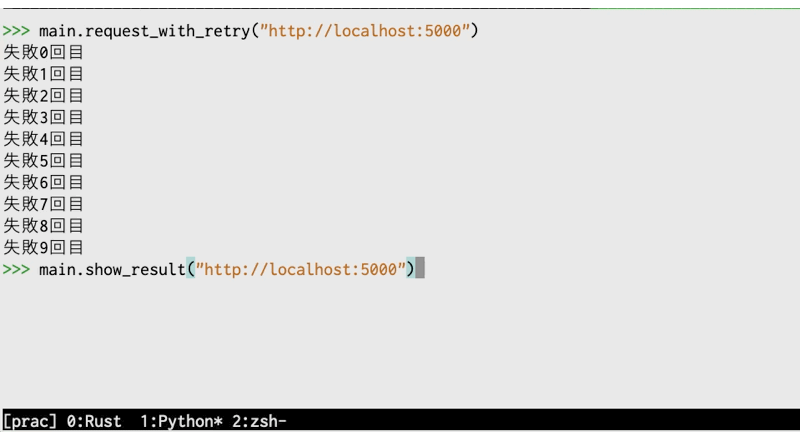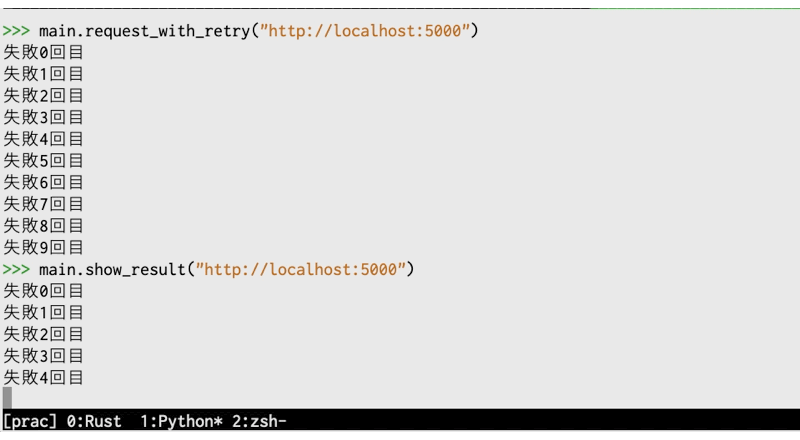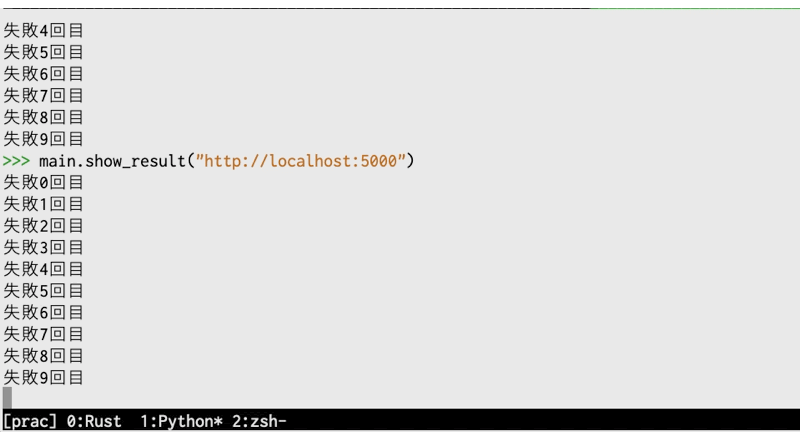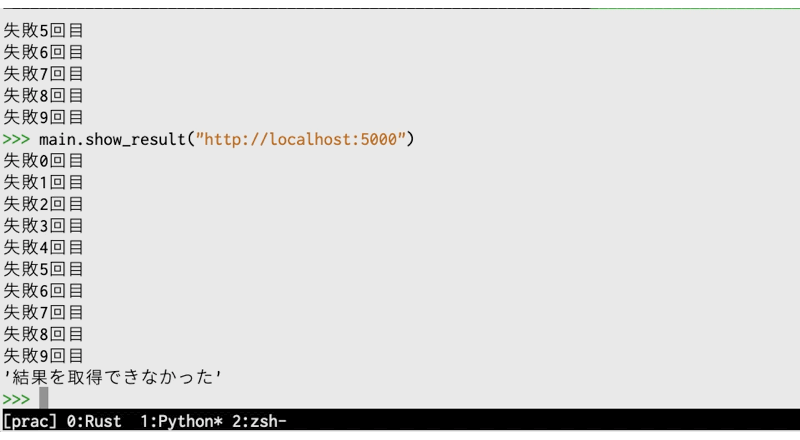
では実際に動かし、挙動を確かめておきましょう。
IPythonをつかって、対話モードに入っています。
import main
main.show_result("http://localhost:5000")
ローカルの5000ポートでは何もうごいていないため、以下の様に表示されます。
リトライするたびに1秒スリープしているため、実行に時間がかかります(gifなので実際より高速に見えますが)。
テスト: 失敗するテストに時間がかかる
さて、それではshow_result関数が結果を取得できないケースのテストを書いていきます。
実装をみると、失敗時には「'結果を取得できなかった'」という文字列を返すのでした。
main.pyに直接テストを書いていきます。今回はunittestを使います。
https://docs.python.org/ja/3/library/unittest.html
from unittest import TestCase

class TestsMyFuncs(TestCase):
    def test_show_result_fail(self):
        url = 'http://localhost:5000'
        actual = show_result(url)
        self.assertEqual(actual, "結果を取得できなかった")
こちらを実行すると、以下の様になります。
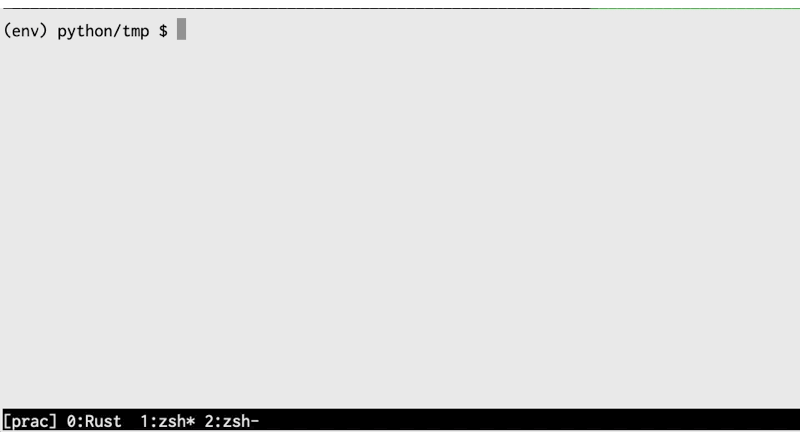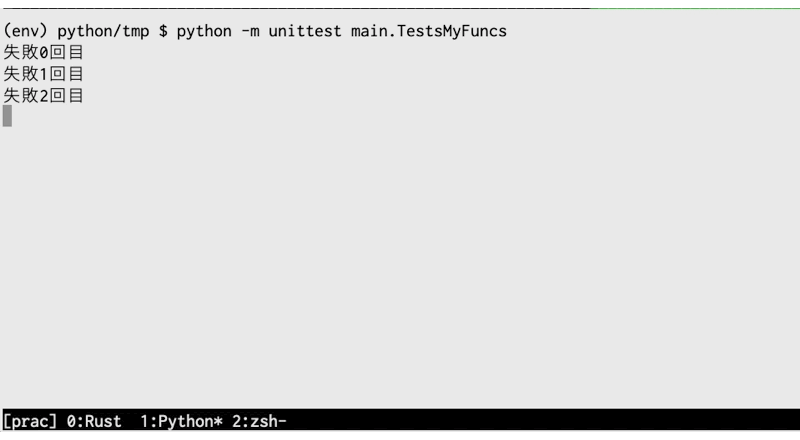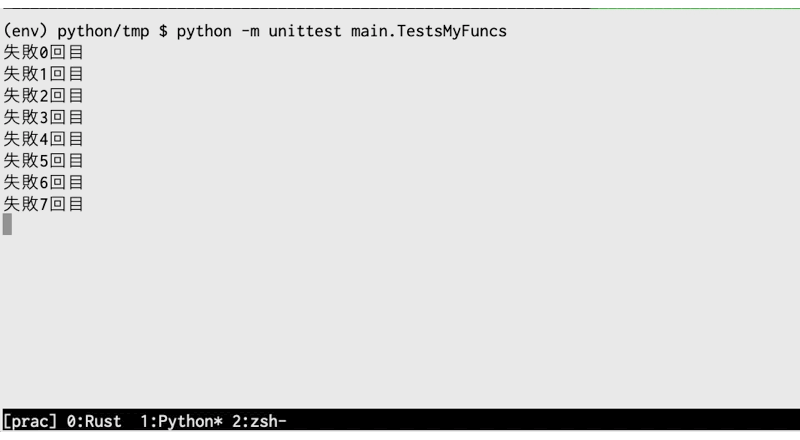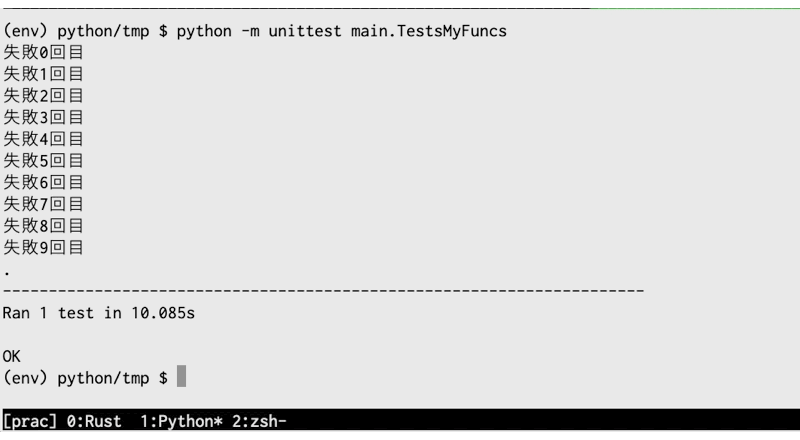
とても時間がかかっています.
単純に時間短縮するならsleepを短くするのも良いかもしれませんが、根本的な問題はリトライ回数のデフォルト値が大きすぎることだと思います。
というわけで、今回はこのデフォルト値を変更する方向で考えてゆきます。
方法0. テストを分ける
いきなりですが脱線します。
そもそも今回のケースは単純なので、テストを分割すれば解決する 問題だと思います。
show_resultは「request_with_retryを呼び、結果がNoneかテキストかによって別の文字列を返す」関数だといえます。
そうすると「URL→結果」を行うのはrequest_with_retry関数であり、このテストでチェックする必要はないです。丸ごとモックしてしまっても良い でしょう。
from unittest import TestCase, mock

class TestsMyFuncs(TestCase):
    def test_show_result_fail(self):
        url = 'http://localhost:5000'
        with mock.patch('main.request_with_retry', return_value=None):
            actual = show_result(url)
        self.assertEqual(actual, "結果を取得できなかった")
テストを実行した結果です。
(env) python/tmp $ python -m unittest main.TestsMyFuncs
.
----------------------------------------------------------------------
Ran 1 test in 0.001s

OK
request_with_retryの機能(失敗したらNone, 成功したらcontentを返す)は、別のテストで確認すれば良いでしょう。
呼び出し時にリトライ回数を2回に制限します。
from unittest import TestCase, mock
from requests.exceptions import ConnectionError

class TestsMyFuncs(TestCase):
# .......省略............
    def test_request_with_retry(self):
        url = 'http://localhost:5000'
        with mock.patch.object(requests, 'get', side_effect=ConnectionError):
            actual = request_with_retry(url, retry=2)  # ここでリトライ数変更
        self.assertIsNone(actual)
テストを実行すると、リトライを2回だけ繰り返しています。
(env) python/tmp $ python -m unittest main.TestsMyFuncs.test_request_with_retry
失敗0回目
失敗1回目
.
----------------------------------------------------------------------
Ran 1 test in 2.002s

OK
ユニットテストは可能な限り分割した方が役に立つし、変更にも強くなると思います。
方法1. __defaults__を書き換える
「方法0. テストを分ける」が可能なら良いのですが、そうは言ってられないケースもあると思います。
まずは デフォルト引数の値自体を書き換える ことにします。
まずは上記リンクで紹介されている、__defaults__を置き換える方法です。
上述のipythonで対話モードに入ります。
>>> import main
>>> main.request_with_retry
<function main.request_with_retry(url, retry=10)>

>>> main.request_with_retry.__defaults__
(10,)
この様に、pythonのFunctionは__defaults__という属性にデフォルト引数で設定した値を持っています。
こちらを差し替えることでリトライ数を変更していきます。
差し替えにはmock.patch.objectを使うと便利だと思います。
unittest.mock --- モックオブジェクトライブラリ — Python 3.10.0b2 ドキュメント
class TestsMyFuncs(TestCase):
    def test_show_result_fail(self):
        url = 'http://localhost:5000'
        with mock.patch.object(request_with_retry, '__defaults__', (2, )): # 2回
            actual = show_result(url)
        self.assertEqual(actual, "結果を取得できなかった")
テストを実行すると、リトライを2回だけ繰り返しています。
(env) python/tmp $ python -m unittest main.TestsMyFuncs
失敗0回目
失敗1回目
.
----------------------------------------------------------------------
Ran 1 test in 2.021s

OK
方法2. partialを使ってデフォルト引数を書き換える
functools --- 高階関数と呼び出し可能オブジェクトの操作 — Python 3.10.0b2 ドキュメント
functoolsモジュールのpartial関数を使う方法です。
こちらは関数の引数に値を渡して、新しい関数を作るようなことができ、テスト以外でも役に立ちます。
実際にみた方が早いので、またまたipythonに入ってゆきます。
>>> import main
>>> from functools import partial

>>> modified = partial(main.request_with_retry, retry=1) # リトライ数を1に固定。

>>> modified('http://localhost:5000')
失敗0回目

# ここで終了している。
以上の様になります。modifiedは、request_with_retry関数のretryを1に固定した新しい関数...というイメージです。
では、テストコードを変更してゆきます。
from functools import partial

class TestsMyFuncs(TestCase):
    def test_show_result_fail(self):
        url = 'http://localhost:5000'
        with mock.patch('main.request_with_retry', side_effect=partial(request_with_retry, retry=2)):
            actual = show_result(url)
        self.assertEqual(actual, "結果を取得できなかった")
テストを実行すると、リトライを2回だけ繰り返しています。
(env) python/tmp $ python -m unittest main.TestsMyFuncs
失敗0回目
失敗1回目
.
----------------------------------------------------------------------
Ran 1 test in 2.026s

OK
自分はこちらの方法をよく使います。__defaults__の書き方と比べて、
- 読みやすい。
- partialは見た目からして「retry=2に書き換えている」というのがわかりやすいと思います。
__defaults__の方はコメントが必要でしょう。retryというパラメータと2が結びつきません。
- 調べやすい。
- partialのDocstringを読めば概要がわかります。
__defaults__のDocstringから、挙動を理解できるとは思えません。
まとめ
テストを分割できれば良いですが、時間の制約や実装を変更できないなどからデフォルト引数の値を変更したいケースが時々出てきます。
自分としてはpartialがおすすめです。
前書きにも書きましたが、
- もっと良い方法
- そもそも論
があればコメントいただけると嬉しいです!
